Aside 브라우저, 클로드와 GPT 중 무엇을 연결해야 할까? 성능 비교
이 글의 독자Aside 브라우저에 클로드나 ChatGPT 구독을 연결해 웹 업무를 맡기려는데, 어느 모델을 골라야 할지 정하지 못한 직장인과 1인 사업자
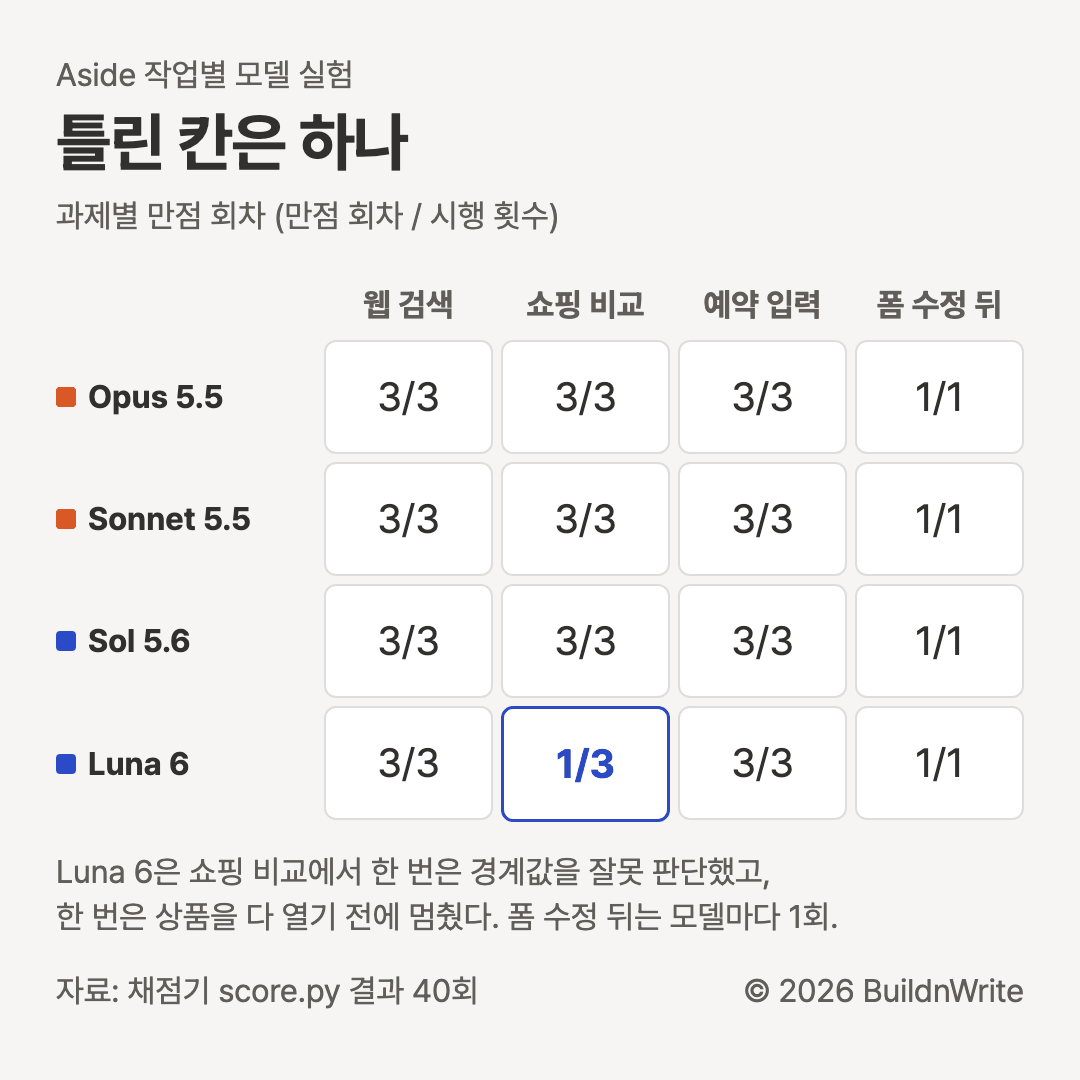
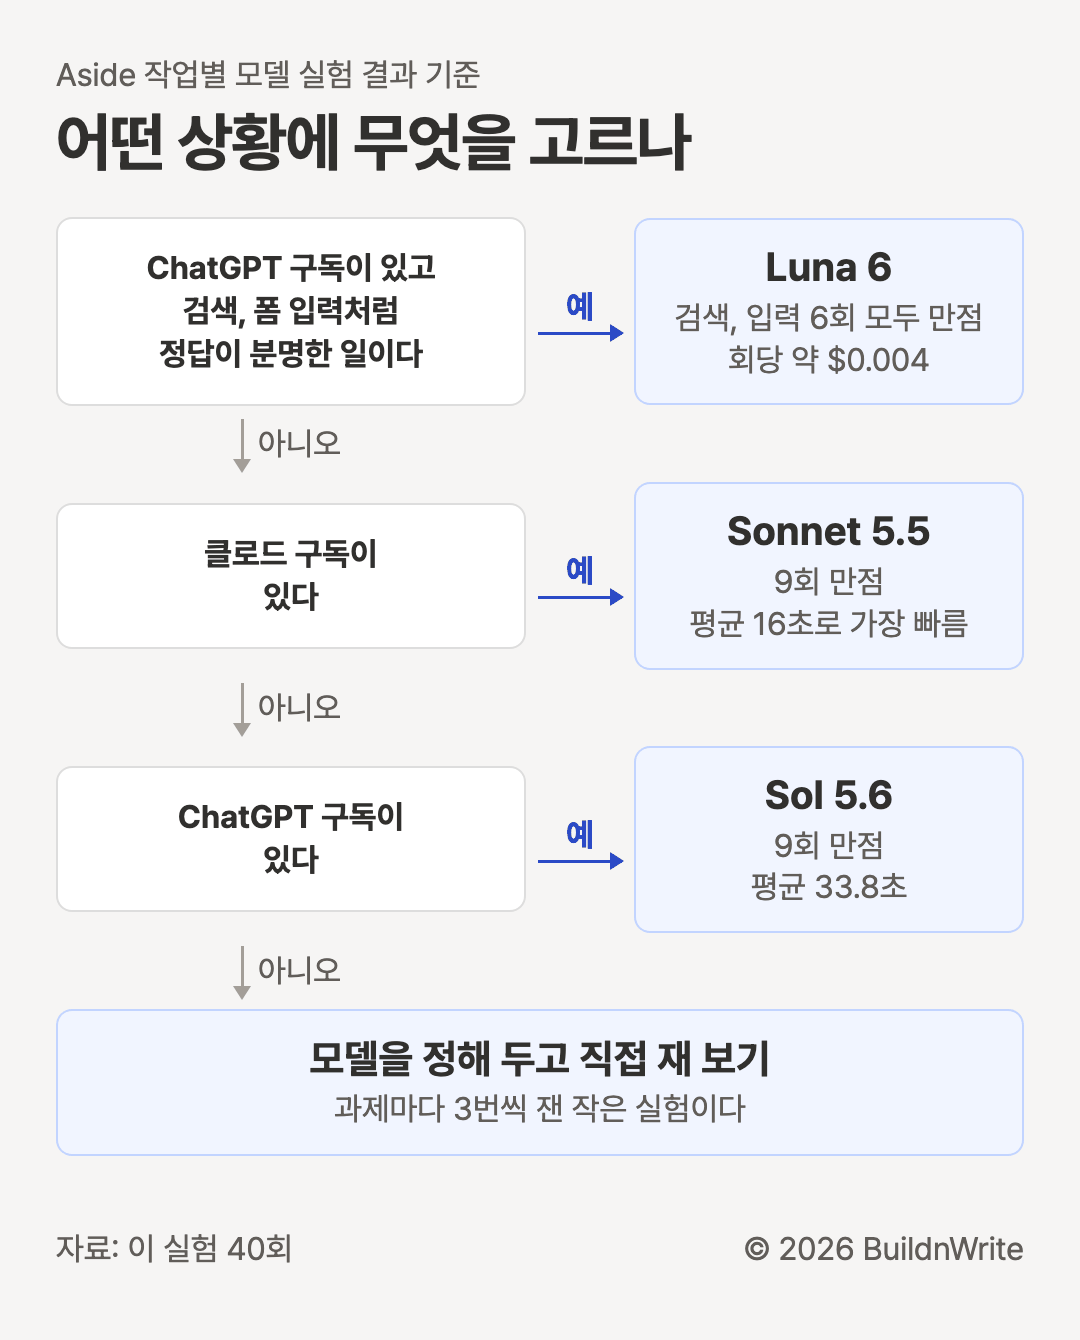
한줄 요약: Aside 브라우저에 모델 4개를 바꿔 연결하고 같은 일 3가지를 9번씩 맡겼습니다. Claude Sonnet 5.5, Claude Opus 5.5, GPT-5.6 Sol은 9번 모두 만점이었고, 가장 싼 GPT-6 Luna는 조건이 여러 개 걸린 쇼핑 비교에서 두 번 틀렸습니다. 검색과 폼 입력은 Luna도 전부 맞혔습니다. 클로드 구독이 있다면 Sonnet, ChatGPT 구독만 있다면 Sol이 이 실험에서 가장 무난했습니다.
Aside는 쓰던 클로드나 ChatGPT 구독을 연결해서 쓰는 AI 에이전트 브라우저입니다. 웹 업무를 AI 에이전트에 맡기려고 설정을 열면 바로 질문이 생깁니다. 둘 다 연결했을 때 어느 모델에 일을 맡겨야 할까요?
Aside가 공개한 공식 벤치마크에는 GPT 모델 한 구성의 결과만 있고, 모델끼리 비교한 표는 없습니다(2026년 10월 6일 확인). 그래서 직접 쟀습니다.
목차
- Aside에 연결하는 모델과 작업별 설정
- 실험 설계
- 결과: 세 모델은 9번 모두 만점
- 어떤 상황에 무엇을 고르나
- Luna가 틀린 두 가지 방식
- 폼 입력은 네 모델 모두 해냈다
- 클로드 연결의 캐시 쓰기 비용
- 이 실험의 한계
- 정리
1. Aside에 연결하는 모델과 작업별 설정
Aside 설정의 Models 화면에서 구독을 연결합니다. 필자는 클로드 구독과 ChatGPT 구독을 둘 다 연결해 두었습니다.
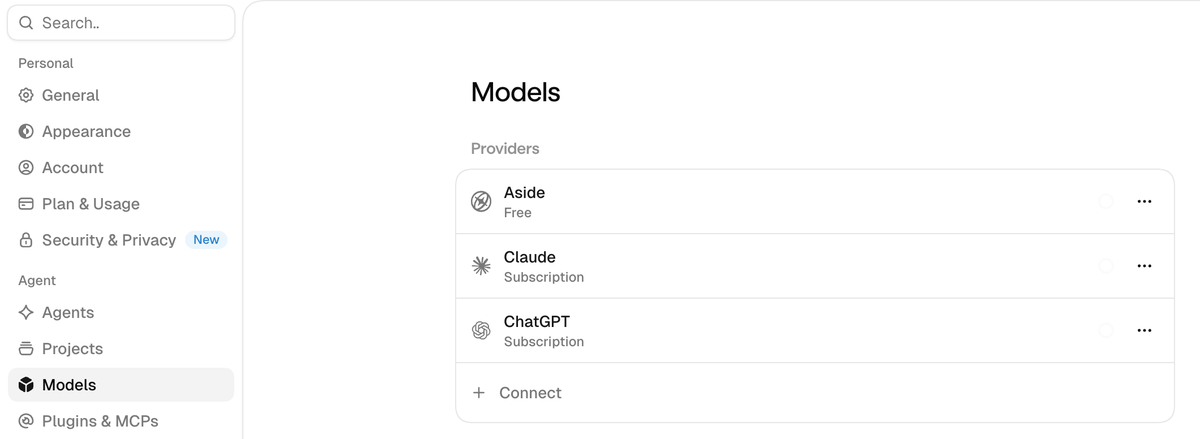
같은 화면 아래 Task models에서는 일의 종류마다 다른 모델을 정할 수 있습니다.
| 칸 | 맡는 일 | 필자 설정 |
|---|---|---|
| Default | 새 대화의 기본 모델 | GPT-6 Luna |
| Fast | 가볍고 짧은 곁일 | GPT-6 Luna |
| Standard | 백그라운드 작업, 기억 정리 | GPT-5.6 Te(화면에서 잘림) |
| Deep | 어려운 추론, 계획, 판정 | GPT-5.6 Sol |
| Visual | 이미지, 스크린샷, 페이지 해석 | GPT-5.6 Sol |
| Image generation | 이미지 생성 | 이 실험에서 쓰지 않음 |
구독을 연결하는 순서는 Aside 브라우저 사용법에 화면과 함께 정리해 두었습니다.
2. 실험 설계
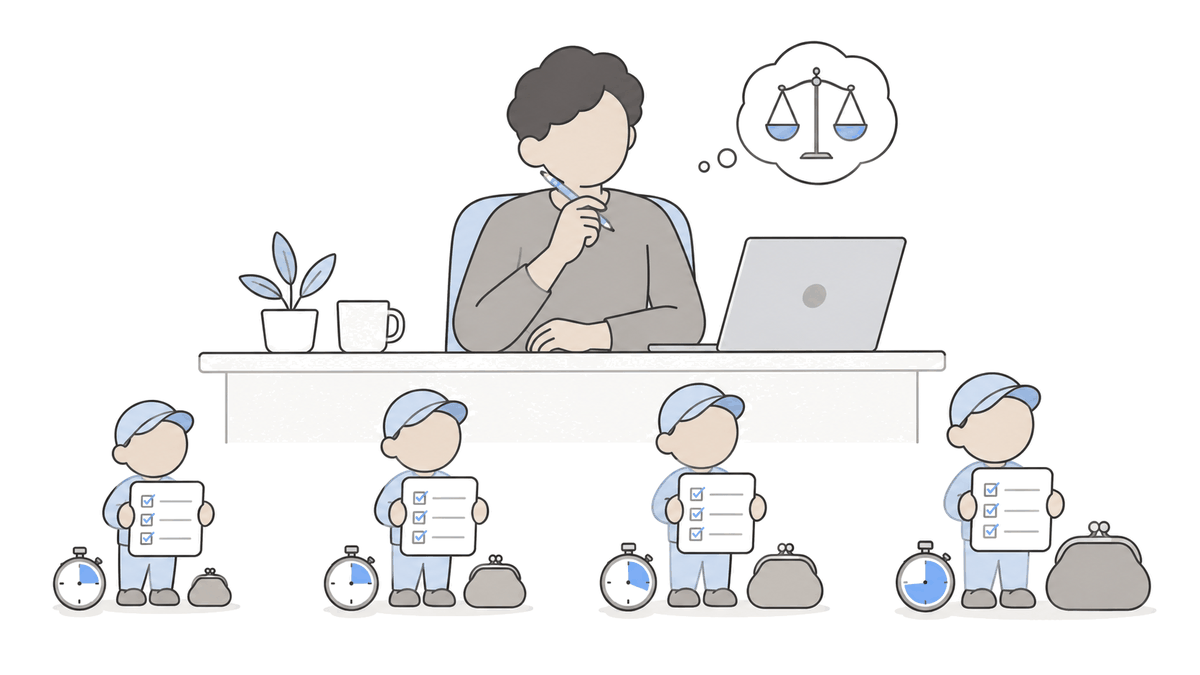
비교가 성립하려면 모델 말고는 전부 같아야 합니다. 과제 문장은 파일 하나에 고정하고, 실행할 때마다 바꾼 것은 연결한 모델 하나뿐입니다.
- 정확도: 채점기가 정답과 대조한 점수
- 소요 시간 초: 세션 첫 기록부터 마지막 기록까지
- 비용 USD: 공식 API 단가로 환산한 값
- 모델 실제값: 로그에 찍힌 모델이 의도와 같은가
- 오류 뒤 복구: 폼 검증 오류를 스스로 고쳤는가
과제는 누구나 브라우저에서 하는 일 세 가지로 골랐습니다. 쇼핑몰과 예약 폼은 필자 맥북에서만 도는 모의 사이트라 실제 주문이나 예약은 생기지 않습니다.
| 과제 | 하는 일 | 대상 | 정답 판정 |
|---|---|---|---|
| 웹 검색 | 공공 정보 질문 3개에 답과 출처 달기 | 실제 웹 | 공식 기관 페이지 값과 대조 |
| 쇼핑 비교 | 이어폰 12개 중 조건 4개 맞는 상품 고르기 | 모의 쇼핑몰 | 조건으로 계산한 정답 3개 |
| 예약 입력 | 2단계 예약 폼에 값 넣고 제출 | 모의 예약 폼 | 서버에 저장된 제출 값 10개 |
| 폼 수정 뒤 | 같은 폼에 필수 항목 하나 추가 | 모의 예약 폼 | 제출 값 11개, 모델마다 1회 |
비용은 로그에 남은 토큰을 공식 API 단가로 계산한 값입니다. 필자는 두 회사 모두 구독으로 연결해 실제 청구는 없었으니, 아래 비용은 전부 API였다면 든 비용으로 읽어 주세요.
3. 결과: 세 모델은 9번 모두 만점
| 연결 | 모델 | 만점 회차 | 평균 점수 | 평균 소요 | 회당 비용 (API 환산) |
|---|---|---|---|---|---|
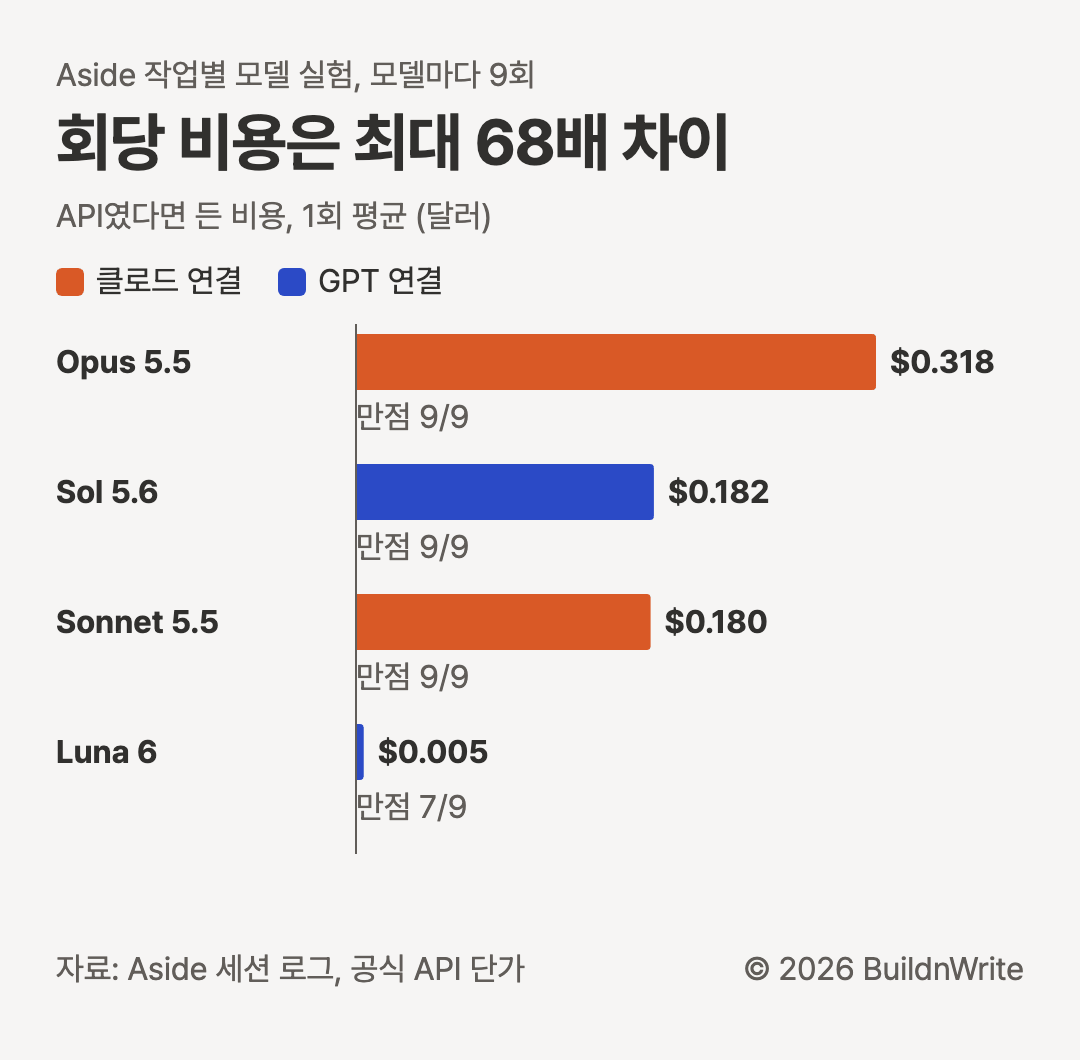
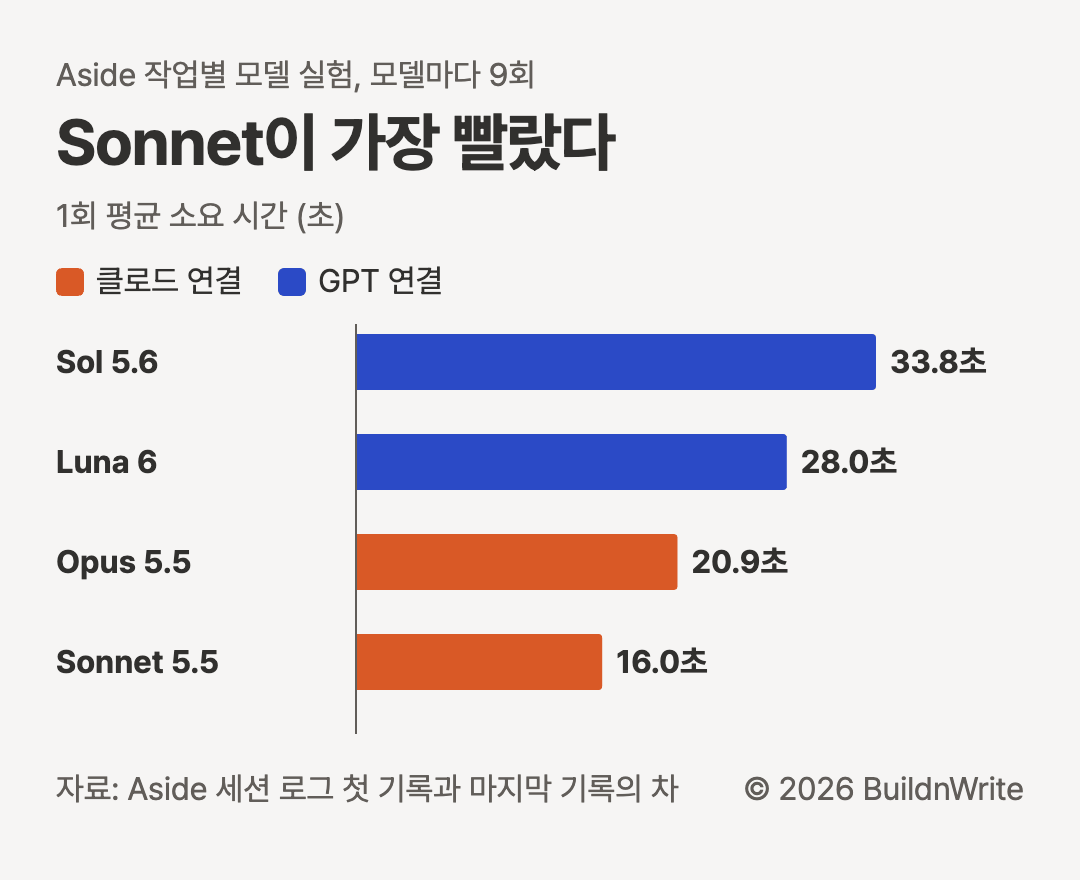
| 클로드 | Claude Opus 5.5 | 9/9 | 1.000 | 20.9초 | $0.318 |
| 클로드 | Claude Sonnet 5.5 | 9/9 | 1.000 | 16.0초 | $0.180 |
| GPT | GPT-5.6 Sol | 9/9 | 1.000 | 33.8초 | $0.182 |
| GPT | GPT-6 Luna | 7/9 | 0.924 | 28.0초 | $0.005 |
4. 어떤 상황에 무엇을 고르나
5. Luna가 틀린 두 가지 방식
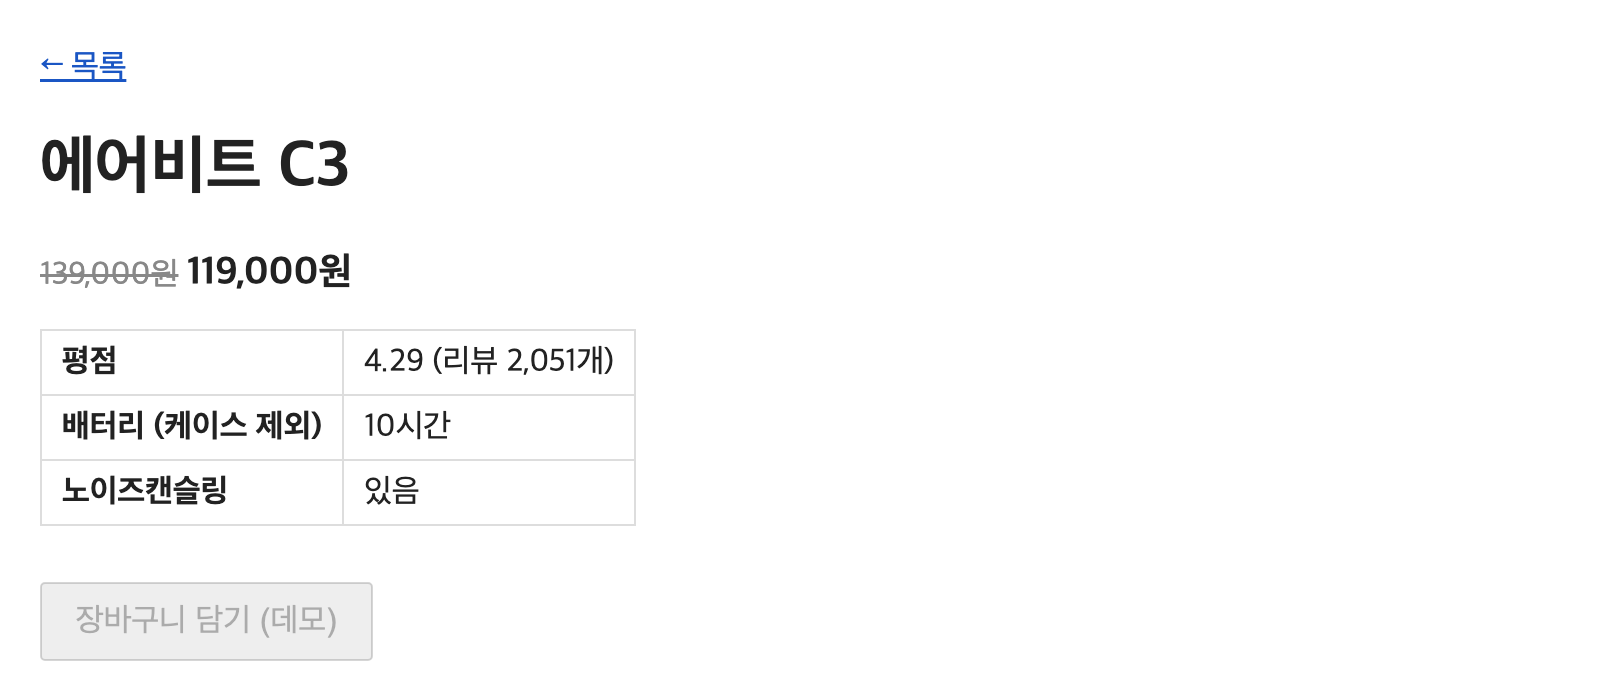
쇼핑 비교의 조건은 네 가지입니다. 할인가 15만 원 이하, 노이즈캔슬링 있음, 배터리 8시간 이상, 평점 4.3 이상. 목록에는 가격과 평점만 보이고, 배터리와 노이즈캔슬링은 상품마다 상세 페이지를 열어야 나옵니다.
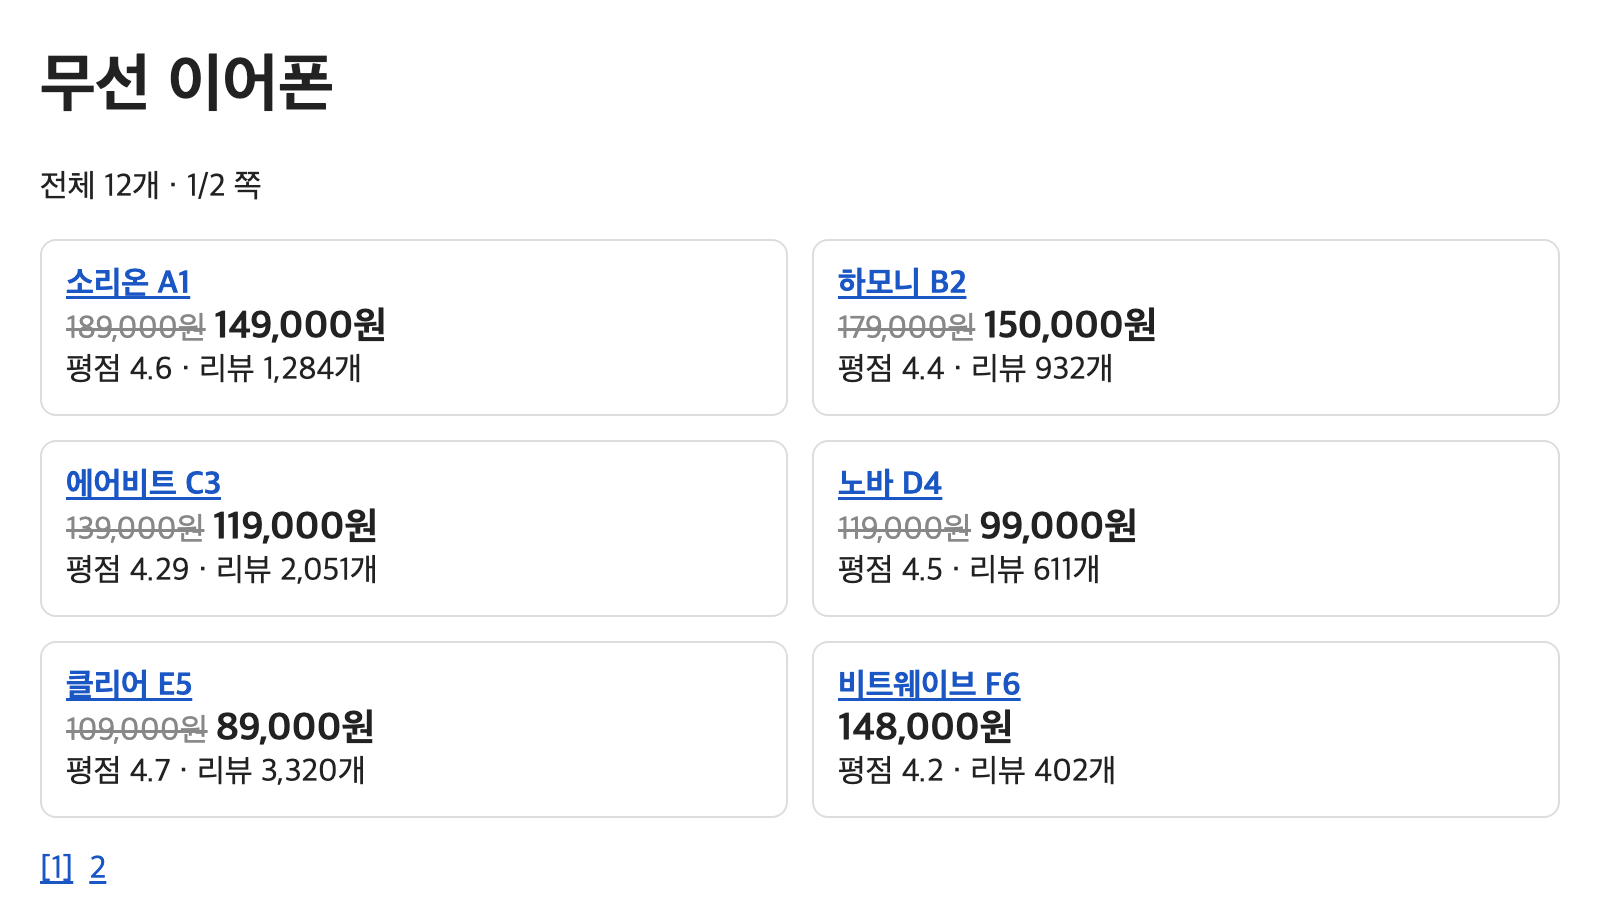
Luna가 틀린 두 번은 틀린 방식이 달랐습니다.
- 1회차, 경계값 판단: 상세 페이지 12개를 다 열었지만 평점 4.29인 에어비트 C3를 넣고, 할인가가 딱 15만 원인 하모니 B2를 뺐습니다.
- 2회차, 탐색 중단: 상세 페이지 2개를 연 뒤 페이지 요소 오류가 나자 멈췄습니다. 2쪽을 열지 않아 오디오포인트 G7이 빠졌고, 답이 미완성이라고 스스로 밝혔습니다.
- 3회차: 정답이었습니다. 나머지 세 모델은 9번 모두 정답이었습니다.
다만 목록의 나머지 상품 상세와 2쪽은 아직 확인하지 못해, 이 결과를 전체 상품 목록으로 확정할 수 없습니다.
(Aside 세션 로그, GPT-6 Luna 쇼핑 비교 2회차 최종 답)
6. 폼 입력은 네 모델 모두 해냈다
예약 폼에는 일부러 함정을 하나 넣었습니다. 휴대폰 번호를 하이픈 없이 주면 폼이 형식 오류를 냅니다.
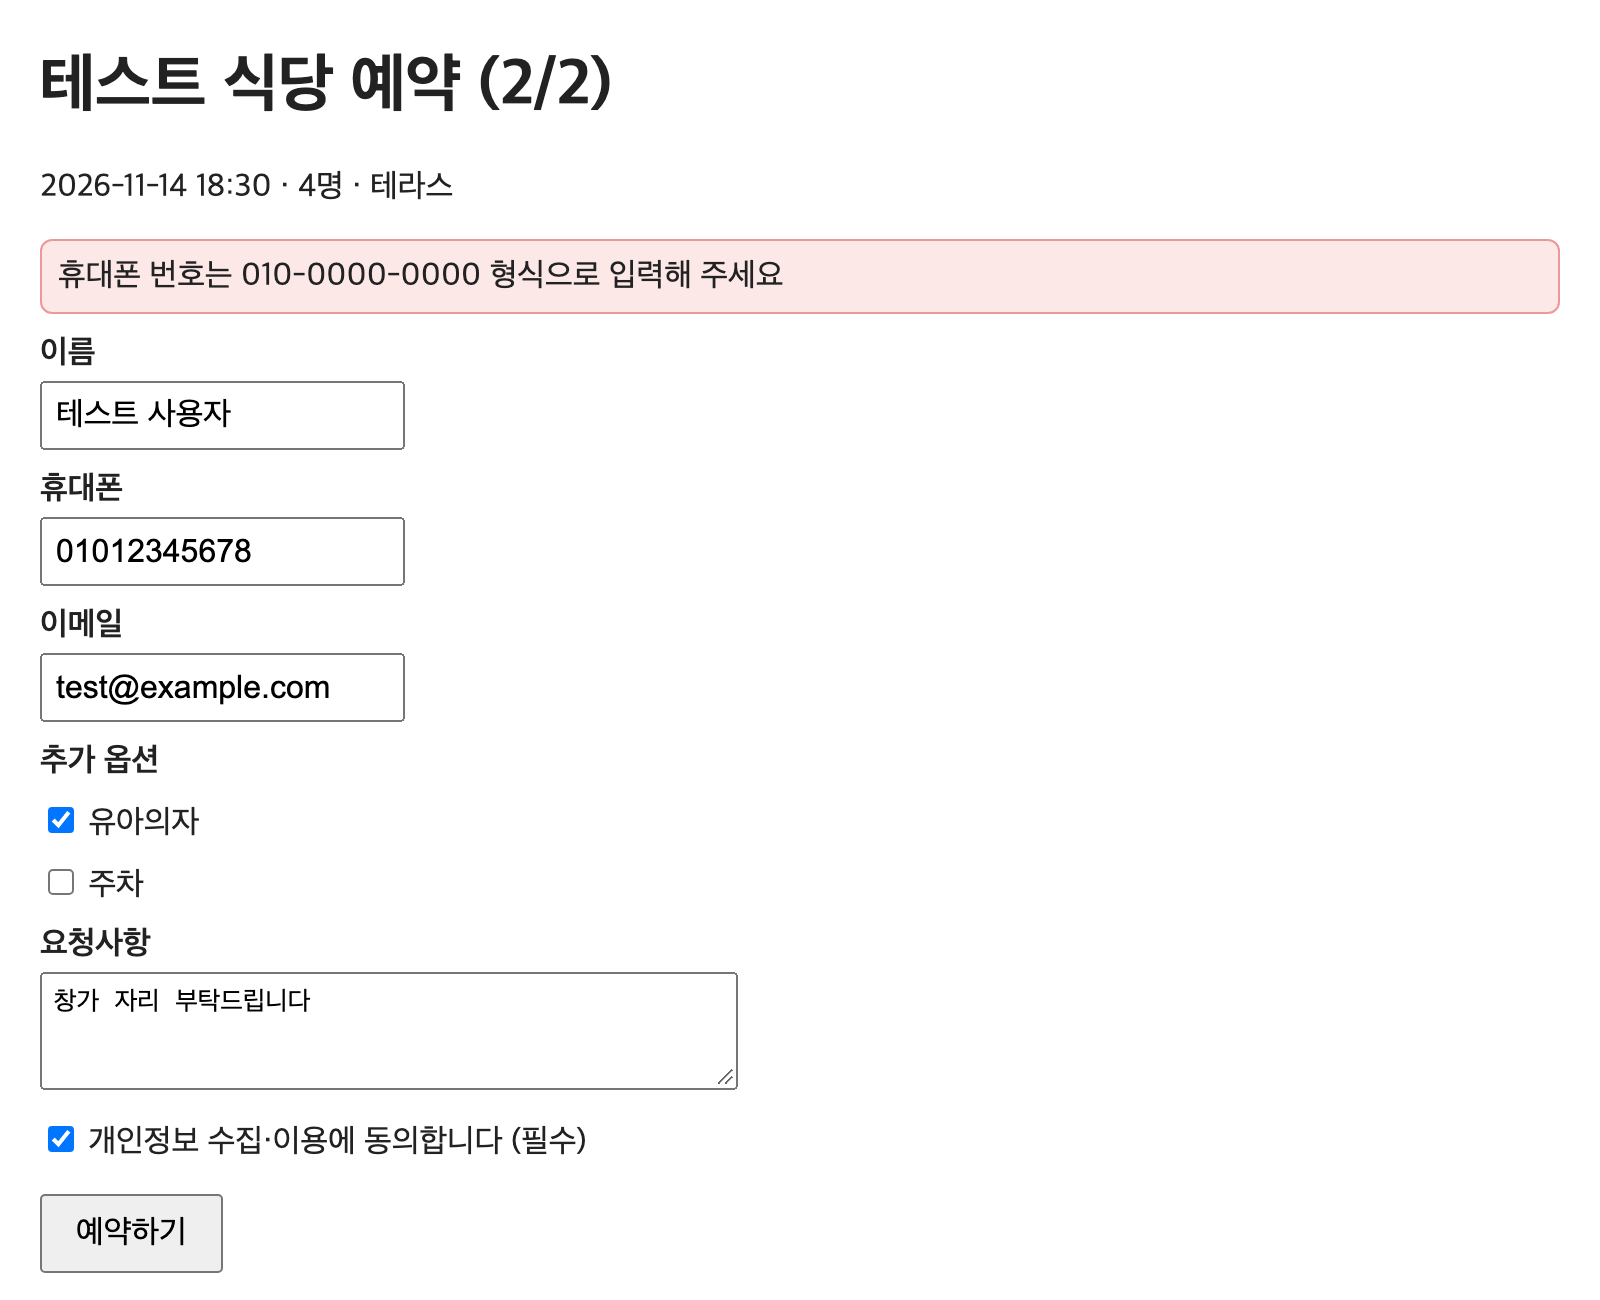
네 모델 모두 매번 이 오류를 받았고, 매번 스스로 010-1234-5678로 고쳐 다시 제출했습니다. 사람이 끼어든 회차는 없었습니다.
예약이 완료됐습니다. 처음 제출했을 때 휴대폰 번호 형식 오류가 나서, 안내대로 010-1234-5678로 고쳐 다시 제출했습니다.
(Aside 세션 로그, Claude Sonnet 5.5 예약 입력 1회차)
폼에 알레르기 필수 항목을 하나 더 넣고 다시 맡겼습니다. 화면이 바뀌어도 네 모델 모두 11개 값을 전부 맞게 제출했습니다.
| 모델 | 제출 값 | 소요 | 비용 (API 환산) |
|---|---|---|---|
| Claude Sonnet 5.5 | 11/11 | 16초 | $0.153 |
| Claude Opus 5.5 | 11/11 | 18초 | $0.266 |
| GPT-5.6 Sol | 11/11 | 38초 | $0.167 |
| GPT-6 Luna | 11/11 | 70초 | $0.006 |
Luna는 화면이 바뀐 폼에서도 정답을 냈지만 70초로 가장 오래 걸렸습니다. 모델마다 한 번씩만 잰 값이라 속도 차이는 참고로만 봅니다.
7. 클로드 연결의 캐시 쓰기 비용
클로드 연결은 세션마다 최소 약 2만 4천에서 2만 7천 토큰을 1시간 캐시에 써 둡니다. 웹 검색처럼 읽을 것이 많은 일에서는 3만 7천에서 6만 1천 토큰까지 늘었습니다. GPT 연결에는 이 캐시 쓰기 비용이 없습니다.
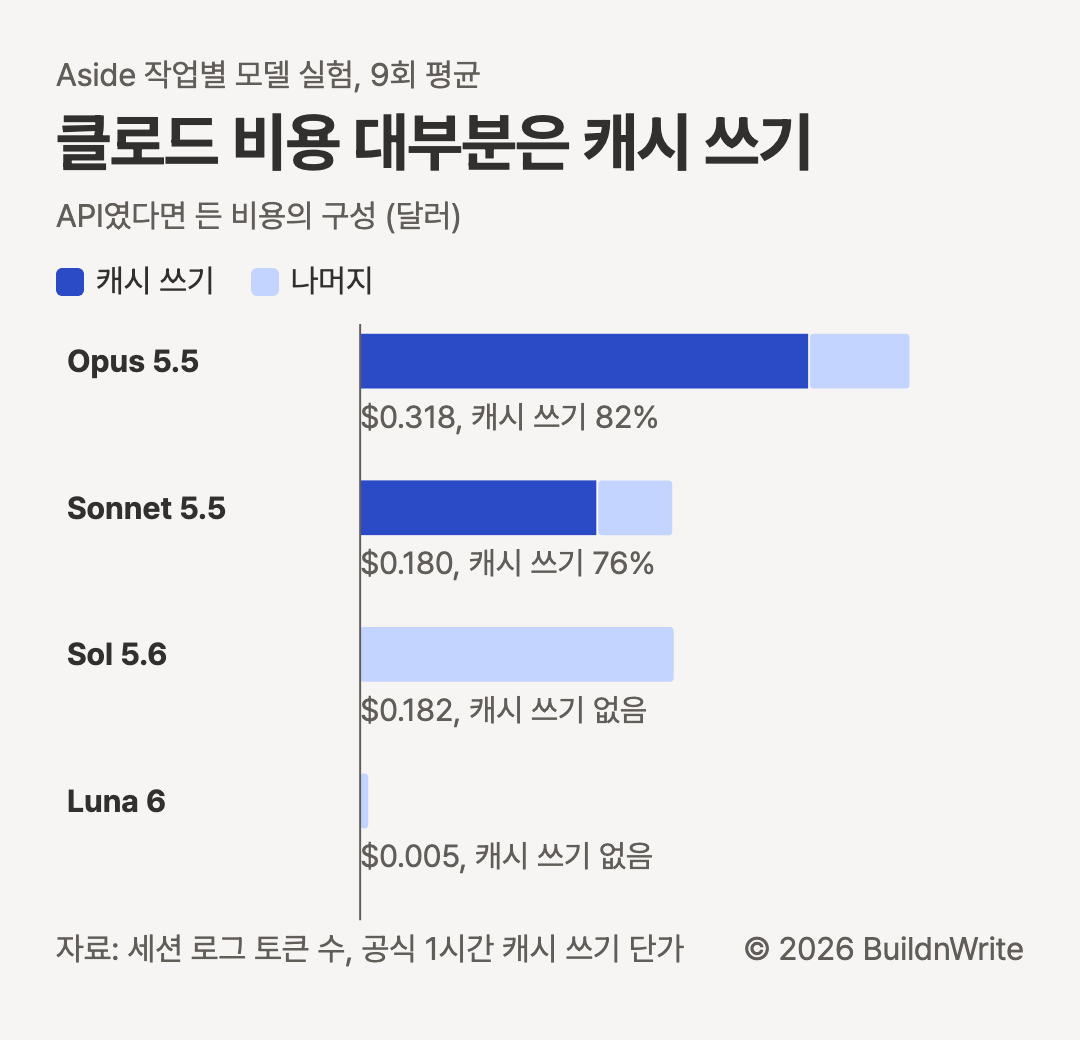
- 9회 평균으로 Opus 5.5는 회당 약 $0.26, Sonnet 5.5는 약 $0.14가 캐시 쓰기입니다(공식 1시간 캐시 쓰기 단가 기준).
- 이번 과제는 한 번에 9초에서 70초 걸리는 짧은 일이라, 일을 처리한 몫보다 캐시 쓰기 몫이 컸습니다.
- 구독으로 연결하면 이 돈이 청구되지는 않습니다. 대신 구독 한도를 얼마나 쓰는지는 이번에 재지 않았습니다.
8. 이 실험의 한계
- 과제마다 3회씩이라 표본이 작습니다. Luna의 2회 오답이 우연인지 경향인지는 이 횟수로 가를 수 없습니다.
- 추론 강도는 medium 한 가지로만 쟀습니다.
- 웹 검색은 답에 든 숫자만 정답과 대조했습니다. 출처 URL이 맞는지는 채점하지 않았습니다.
- 쇼핑몰과 예약 폼은 로컬 모의 사이트 2개입니다. 실제 사이트의 팝업, 로그인, 느린 응답은 들어 있지 않습니다.
- 기억 정리 같은 백그라운드 작업 비용은 세션 로그 밖에 있을 수 있습니다.
- 구독 한도를 얼마나 쓰는지는 재지 않았습니다.
9. 정리
자주 묻는 질문
- Aside 브라우저에는 클로드와 GPT 중 무엇을 연결하는 게 좋나요?
- 필자의 실험(같은 일 3가지, 모델마다 9회)에서는 Claude Sonnet 5.5, Claude Opus 5.5, GPT-5.6 Sol이 9번 모두 만점이었고 GPT-6 Luna는 쇼핑몰 조건 비교에서 두 번 틀렸습니다. 가장 빠른 모델은 Sonnet 5.5(평균 16.0초)였습니다. 표본이 작은 실험이라 내 업무로 한 번 더 재 보기를 권합니다(2026년 10월 6일 실측).
- Aside에서 모델을 지정하지 않으면 어떤 모델로 도나요?
- 그때 설정에 있는 기본 모델로 돕니다. 필자도 같은 날 오전에는 Opus, 설정을 바꾼 오후에는 Luna로 돌았습니다. 모델끼리 비교할 때는 실행할 때마다 모델을 지정해야 합니다.
댓글