옵시디언 그냥 쓰면 안 됩니다. 메모리는 계층부터 나눠야 합니다
이 글의 독자AI 에이전트에 맥락을 기억시키고 싶은 1인 사업자와, 에이전트 여러 개를 직접 굴리는 실무자
한줄 요약: 모델의 값과 한도는 제공사가 정합니다. 언제든 갈아탈 수 있으려면 기억을 모델 밖에 두되, 단기기억, 사실, 이해, raw data 네 층으로 나눠 두고 옵시디언은 보기 창으로만 씁니다.
목차
- 모델의 주권은 우리에게 없습니다
- 메모리를 md 파일 하나에 몰면 생기는 일
- 제 메모리는 네 층입니다
- 그럼 옵시디언은 어디에 두나요
- 층이 섞이지 않게 지키는 규칙 셋
- 오늘 바로 시작한다면
1. 모델의 주권은 우리에게 없습니다
요즘 AI 요금 공지가 부쩍 잦습니다. Anthropic은 Fable을 7월 7일부터 구독에서 빼겠다고 했다가, 7월 20일 상위 요금제(Max, Team Premium)에만 남기고 그 아래 요금제는 API 단가 수준의 사용량 크레딧으로 돌렸습니다.12 OpenAI는 GPT Pro 200달러 요금제의 사용량을 20배에서 10배로 줄이겠다고 알렸다가, 10월 29일 그 계획을 거둬들였습니다.34 몇 달 사이에 쓸 수 있는 양과 내는 돈이 몇 번씩 바뀝니다.
이 공지를 받는 사람은 고를 수 있는 것이 없습니다. 모델을 쓰는 사람은 우리지만 값과 한도를 정하는 쪽은 제공사입니다. 모델의 주권이 우리에게 없다는 뜻입니다. 그렇다면 할 수 있는 일은 하나입니다. 더 낫거나 더 싼 모델이 나오면 언제든 갈아탈 수 있게 준비해 두는 것입니다.
저는 실제로 그렇게 일합니다. 화면을 보며 대화하는 일은 Opus, 밤새 혼자 도는 일은 Fable, 반복 작업은 Haiku에게 맡깁니다. Claude 사용량을 다 쓴 날은 Codex로 넘어가 하던 일을 이어서 했습니다. 모델이 바뀌어도 일이 멈추지 않았던 데는 이유가 있습니다.
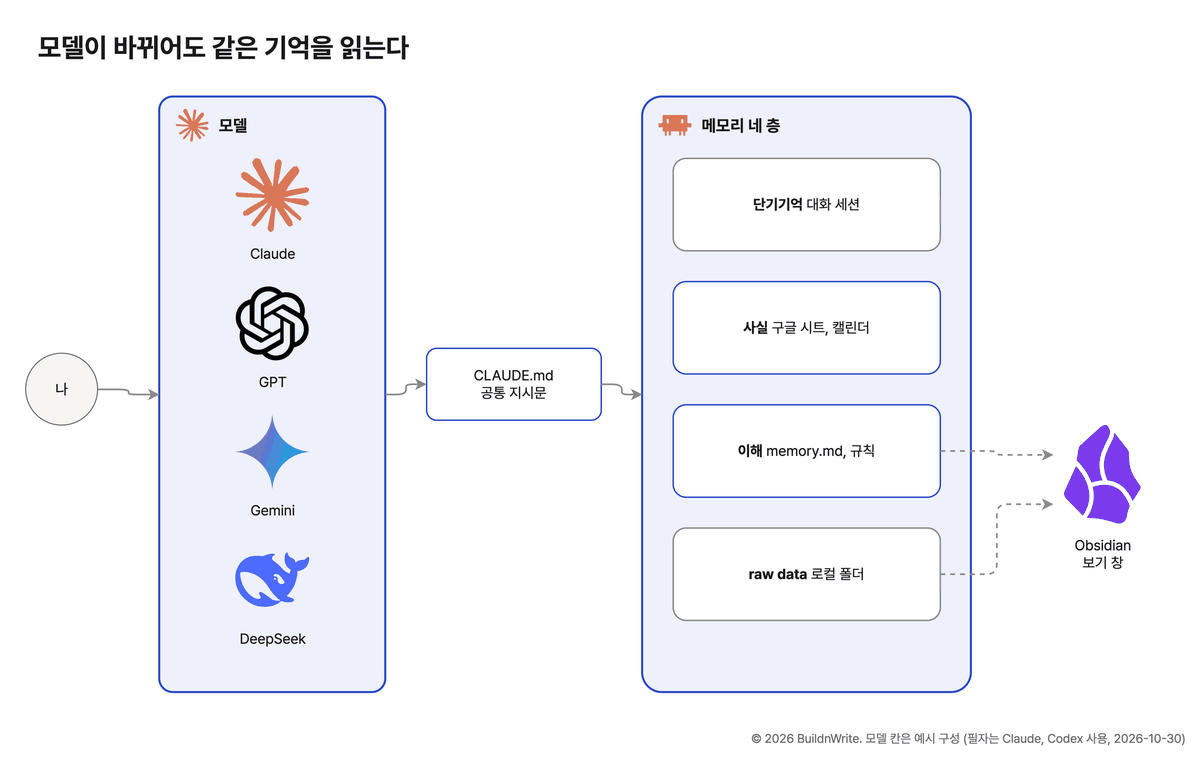
첫째, 지시문을 특정 에이전트에 묶지 않았습니다. 제 작업 규칙은 Claude Code가 읽는 CLAUDE.md에 있는데, Codex도 설정 한 줄로 같은 파일을 읽게 해 두었습니다. 에이전트가 바뀌어도 같은 규칙을 봅니다.
둘째, 기억을 모델 밖에 두었습니다. 거래처 이름, 제가 싫어하는 문장, 지난주에 어디서 실수했는지는 모델이 외우고 있지 않습니다. 파일과 시트에 있고, 어느 모델이든 첫날부터 그걸 읽습니다. 그런데 기억을 한곳에 모은다며 옵시디언 같은 도구 안으로 전부 옮기면, 이 준비가 다시 한 도구에 묶입니다.
2. 메모리를 md 파일 하나에 몰면 생기는 일
메모리가 중요하다는 말에는 다들 동의합니다. 문제는 그다음입니다. 어디에 둘까요? 메모리를 에이전트가 읽는 md 파일 하나로 생각하면, 기억할 만한 것을 전부 그 파일에 적게 됩니다. 거래처 연락처, 이번 달 단가, 내가 좋아하는 말투, 지난 회의 내용이 한 파일에 섞입니다.
이렇게 섞으면 무너지는 것이 있습니다.
- 정확성. 단가가 바뀌면 파일 속 문장도 고쳐야 합니다. 문장 속 숫자는 고치는 사람도 놓치고, 읽는 에이전트는 옛 값을 믿습니다.
- 판단. 회의 녹취 같은 raw data가 취향 메모 사이에 끼면, 에이전트는 긴 기록을 훑느라 “이 사람은 이런 걸 싫어한다”는 한 줄을 놓칩니다.
구글 클라우드 테크가 10월 28일 공개한 에이전트 메모리 영상5도 같은 지점을 짚습니다. 12분짜리라 한 번 볼 만합니다.
메모리는 두 종류다. 정확해야 하는 사실은 데이터베이스에, 뜻을 담는 이해는 뜻이 비슷한 기억을 찾아 주는 저장소에 둔다. 카메라 영상이나 음성 같은 raw data는 메모리가 아니라 따로 보관할 문제다. (Google Cloud Tech 영상 요지, 필자 번역)
영상은 흔한 실수도 짚습니다. 사실까지 모두 의미 검색 저장소에 넣는 것입니다. “내가 뭘 샀지?“처럼 답이 정확해야 하는 질문에 비슷한 기억이 돌아오면 위험합니다. 저장 시점도 나눕니다. 사실은 일어난 즉시 저장하고, 이해는 무엇을 남길지 알 만큼 맥락이 쌓인 뒤에 저장합니다.
기업은 이걸 Cloud SQL(구글의 표 형식 데이터베이스)과 벡터 데이터베이스(뜻이 비슷한 글을 찾아 주는 저장소)로 만듭니다. 그런데 영상도 벡터 저장소는 제품이 아니라 범주라고 말합니다. 뜻으로 찾을 수만 있으면 됩니다. 제 환경에서는 모델이 파일 목록(색인 파일)을 읽고 필요한 파일을 골라 오는 방식이 그 역할을 합니다. 1인 사업자는 같은 구조를 이미 쓰는 도구로 만들 수 있습니다.
| 영상의 구성 | 1인 사업자의 대응 |
|---|---|
| 구조화 DB (Cloud SQL, Postgres) | 구글 시트, 캘린더 |
| 벡터 저장소 | md 파일 + 색인 파일 |
| 관리형 기억 추출 (Memory Bank, 대화에서 기억할 것을 뽑아 주는 구글 서비스) | 메모리 기록 규칙 + 주 1회 위키 정리 |
| 원본 미디어 저장소 | 로컬 폴더 |
3. 제 메모리는 네 층입니다
첫째 층은 단기기억, 대화 세션입니다. 지금 에이전트와 나누는 대화가 단기기억입니다. 컴퓨터의 RAM처럼 일하는 동안만 쓸모 있고, 세션이 끝나면 다음 대화로 넘어가지 않습니다. 그래서 세션마다 물어야 할 질문은 “다 저장할 수 있는가”가 아니라 “다음 세션에 무엇을 넘길 가치가 있는가”입니다. 구글 영상도 이 질문을 짚습니다.
둘째 층은 사실입니다. 사실은 사실 그대로 둡니다. 회신을 기다리는 업무, 거래처 연락처, 단가표는 구글 시트에 있고, 일정은 구글 캘린더에 있습니다. 에이전트는 이 값을 외우지 않고 필요할 때 엽니다. “다음 주에 미팅 잡을 시간 있어?“라고 물으면 비슷한 기억을 떠올리는 대신 캘린더의 실제 일정을 읽어 옵니다.
셋째 층은 이해입니다. 취향과 판단은 memory.md에 둡니다. Claude Code는 프로젝트마다 메모리 폴더를 따로 두고, 제 환경에서는 그 안에 한 파일에 한 가지만 적게 합니다. “블로그 글에 면책 문장을 넣지 않는다”, “링크드인 일상 글은 장면을 생생하게 쓴다” 같은 것들입니다. 제가 에이전트를 고쳐 준 순간이나 맞다고 확인해 준 순간에 바로 적힙니다. 파일 목록을 한 줄씩 모은 색인 파일 MEMORY.md는 제 Claude 환경에서 세션이 시작될 때 자동으로 읽힙니다. 지금 이런 메모리 파일이 621개 있습니다.
이해에는 갈래가 하나 더 있습니다. 메모리는 프로젝트 폴더별로 갈려 있어서, 블로그 프로젝트에서 배운 것을 강의 프로젝트는 모릅니다. 그래서 어느 프로젝트에서나 맞는 원칙은 따로 모은 규칙 파일로 올리고, 조사한 지식은 일주일에 한 번 위키로 정리합니다. 걸러서 올리는 이 갈래가 영상이 말한 “맥락이 쌓인 뒤에 저장한다”와 같은 방식입니다.
넷째 층은 raw data입니다. 회의 녹음, 전사본, 조사할 때 받아 둔 원문, 에이전트와 나눈 대화 기록 전체가 여기에 들어갑니다. 로컬 폴더에 그대로 둡니다. 대화가 끝날 때마다 스크립트가 세션 기록을 파일로 저장하는데, 지금까지 1,031개가 쌓였습니다.
영상은 raw data를 메모리 밖에 두라고 했습니다. 저는 그 원본을 회고용으로 한 층 더 둡니다. 네 층은 영상의 두 구분 위에 제가 얹은 해석입니다. raw data를 따로 두는 이유가 있습니다. 에이전트는 평소에 얕게 찾습니다. 제 시스템이 기본으로 훑는 범위는 최근 30일의 세션까지입니다. 일상 업무에는 그걸로 충분합니다. 하지만 연간 회고를 쓰거나 몇 달 전에 끝난 프로젝트에서 왜 그렇게 정했는지 찾을 때는 모자랍니다. 그때 raw data 폴더를 엽니다.
| 층 | 무엇을 두나 | 언제 쓰나 | 언제 읽나 |
|---|---|---|---|
| 단기기억 | 지금 하는 일의 맥락 | 대화하는 동안 | 그 세션 안에서만 |
| 사실 | 일정, 연락처, 단가 | 일어난 즉시 | 필요할 때 조회 |
| 이해 | 취향, 교정, 일하는 방식 | 고쳐 주거나 확인한 순간 | 세션 시작 때 색인 |
| raw data | 대화 기록, 녹음, 원문 | 세션이 끝날 때 자동 저장 | 회고, 지난 프로젝트를 찾을 때 |
4. 그럼 옵시디언은 어디에 두나요
여기까지 이야기하면 꼭 나오는 질문이 있습니다. “그러니까 옵시디언에 다 모으라는 거죠?” 옵시디언을 메모리 저장소로 쓰면 메모리, 회의록, 자료를 전부 볼트 안으로 옮기게 됩니다. 그러면 위에서 나눈 층이 다시 한 곳에 섞입니다.
저는 처음부터 옵시디언을 저장소로 쓰지 않았습니다. 제 볼트를 열면 memory, sessions, wiki 세 폴더가 보입니다. 이 셋은 진짜 폴더가 아니라 원래 자리의 폴더를 가리키는 바로 가기(심볼릭 링크)입니다. memory는 Claude Code가 쓰는 공용 메모리 폴더를, sessions와 wiki는 iCloud에 있는 대화 기록 폴더와 정리한 지식 폴더를 가리킵니다. 에이전트는 그 원래 폴더에 쓰고, 지금 보는 볼트는 그 폴더들을 가리키기만 합니다. 파일은 한 개도 옮기지 않았습니다.
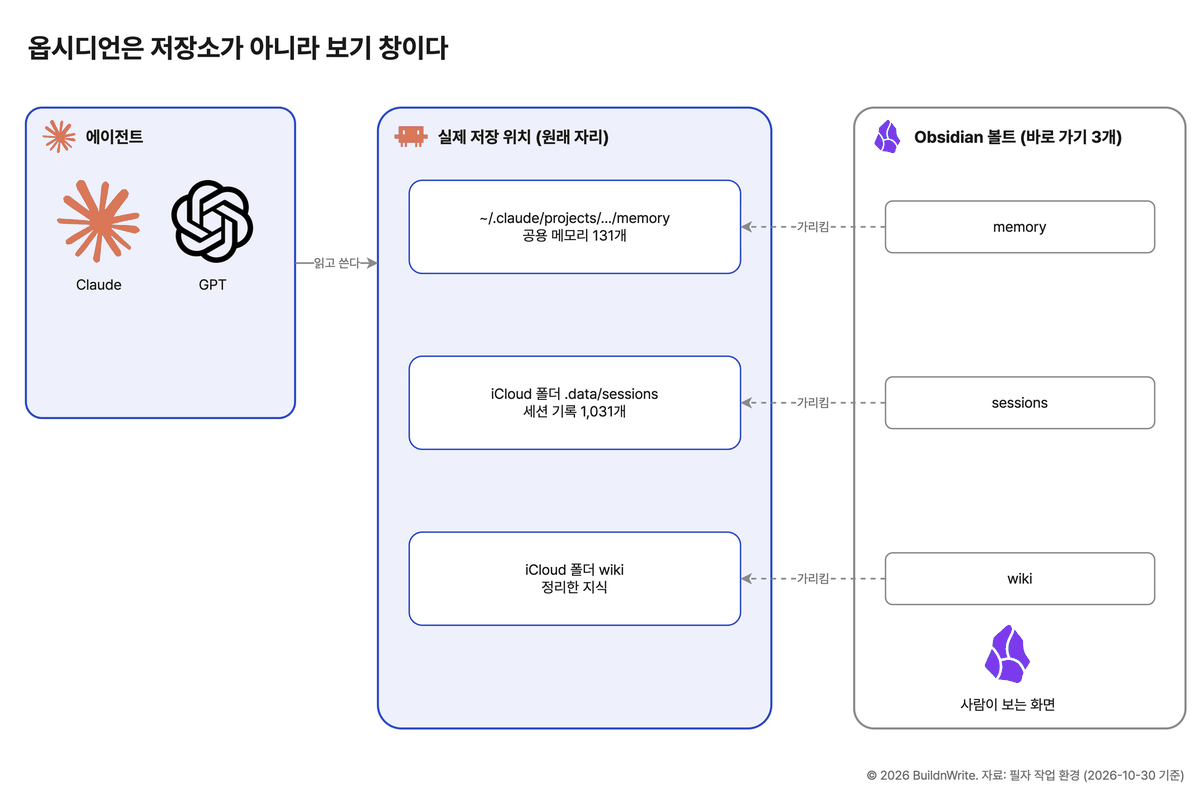
옵시디언은 저장소가 아니라 뷰입니다. 이미 가진 디렉터리를 사람이 읽기 좋게 보여 주는 창입니다. 에이전트는 원래 자리에서 읽고 쓰고, 저는 옵시디언에서 그 결과를 한 화면으로 봅니다. 이렇게 두면 좋은 점이 있습니다.
- 에이전트가 쓰는 경로가 바뀌지 않으니 아무것도 깨지지 않습니다.
- 옵시디언을 다른 도구로 바꿔도 데이터는 원래 자리에 그대로 있습니다.
- 링크와 검색, 그래프 보기 같은 옵시디언의 장점은 다 쓸 수 있습니다.
모델을 바꿔 끼울 수 있어야 하는 것처럼, 보는 도구도 바꿔 끼울 수 있어야 합니다.
5. 층이 섞이지 않게 지키는 규칙 셋
층을 나눠도 쓰다 보면 경계가 흐려집니다. 저는 아래 규칙으로 막습니다.
값은 한 곳에만 있어야 바뀔 때 한 곳만 고칩니다. “이 거래처는 회신이 늦다”가 시트에 세 번 적혔다면, 그건 더 이상 값이 아니라 판단입니다.
6. 오늘 바로 시작한다면
별도의 검색용 데이터베이스도, 메모리 서비스도 없이 시작할 수 있습니다.
- 지시문은 여러 에이전트가 같이 읽는 파일 하나에 둡니다.
- 정확해야 하는 값(일정, 연락처, 가격)은 구글 시트나 캘린더에 둡니다.
- 에이전트를 고쳐 준 내용은 그 자리에서 메모리 파일 한 장에 한 가지씩 적게 합니다.
- 녹음, 원문, 대화 기록은 로컬 폴더에 그대로 쌓습니다.
- 옵시디언을 쓴다면 파일을 옮기지 말고, 볼트에서 그 폴더들로 바로 가기를 겁니다. 맥은 터미널에서
ln -s 원래폴더 볼트/이름, 윈도우는 명령 프롬프트에서mklink /D 볼트\이름 원래폴더로 만듭니다.
다음 달에도 요금 공지는 또 올 것입니다. 그때 새 모델로 갈아타는 데 걸리는 시간은 메모리를 어떻게 나눠 두었느냐가 정합니다. 지금 쓰는 에이전트가 무엇이든, 기억이 어디에 있는지부터 한 번 살펴보시면 좋겠습니다.
참고 자료 5건
- PCWorld, Fable will stay in Claude plans, but not for everyone ↩
- BleepingComputer, Claude Fable 5 isn't permanently leaving subscriptions, Anthropic says ↩
- OpenAI, ChatGPT Release Notes (2026-10-29) ↩
- XenoSpectrum, ChatGPT Pro Doubles Work and Codex Usage Limits as OpenAI Reverses Pro 200 Cut ↩
- Google Cloud Tech, AI Agent Memory Architecture: Structured SQL, Semantic Vector Search & Memory Bank (YouTube, 2026-10-28) ↩
자주 묻는 질문
- 클로드 메모리를 md 파일 하나에 다 적으면 안 되나요?
- 처음에는 됩니다. 다만 단가처럼 바뀌는 값과 취향 메모, 회의 기록이 한 파일에 섞이면 옛 값을 믿거나 중요한 한 줄을 놓치게 됩니다. 정확해야 하는 값은 시트에, 취향과 판단은 메모 파일에, 원본 기록은 폴더에 나눠 두는 편이 낫습니다.
- 옵시디언에 파일을 모두 옮겨야 하나요?
- 옮기지 않아도 됩니다. 볼트에서 원래 폴더로 바로 가기(심볼릭 링크)를 걸면 에이전트는 원래 자리에서 읽고 쓰고, 사람은 옵시디언에서 한 화면으로 봅니다.
댓글