AI 업무 자동화, 어떤 모델에 맡길까: 실제 작업 11개로 GPT 루나와 클로드 하이쿠 비교
이 글의 독자다이어그램, 문서, 블로그 초안, 브라우저 작업 같은 반복 업무를 AI에 맡기려는데, 싼 모델로도 쓸 만한 결과물이 나오는지 비용과 함께 알고 싶은 직장인과 1인 사업자
한줄 요약: 다이어그램, 슬라이드, 문서, 블로그 초안, 브라우저 작업까지 실제 업무 11가지를 모델 5개에 3번씩 맡겼습니다. 정해 둔 규격은 하이쿠 5.5와 소넷 5.5가 33번 모두 지켰고, 비용은 하이쿠 5.5가 소넷의 약 12.6분의 1이었습니다. 반대로 그림, 차트, 문서를 모델 이름을 가리고 사람이 채점한 점수(평가자 1명)는 가장 싼 GPT-6 Luna가 가장 높았습니다. 규격을 스크립트로 검사하는 자동화라면 하이쿠 5.5, 사람이 다듬을 시각 결과물 초안이라면 GPT-6 Luna가 이 실험에서 가장 경제적이었습니다.
목차
- 작은 과제에서는 비슷했던 두 모델
- 실험 설계
- 결과: 기계 채점과 사람 채점이 갈렸다
- 어떤 상황에 무엇을 고르나
- 결과물 나란히 보기
- 틀린 장면들
- 비용, 시간, 성능
- 이 실험의 한계
- 정리
1. 작은 과제에서는 비슷했던 두 모델
앞선 실험에서는 발표문 추출, 문의 분류, 코드 수정 같은 작은 판정 과제 6개로 하이쿠 5.5와 GPT 루나를 비교했습니다. 6과제 중 4과제가 다섯 모델 모두 만점이라, 하이쿠 5.5와 GPT-6 Luna의 점수 차이를 가를 수 없었습니다.
이번에는 질문을 바꿨습니다. 실제로 반복해서 맡기는 일, 그러니까 결과물이 그림이고 문서이고 브라우저 조작인 일에서도 같은가입니다.
- 과제는 지난 90일 동안 필자가 AI에 맡긴 대화 334건을 작업 종류별로 세어, 자주 하는 일 위주로 골랐습니다.
- 카드뉴스는 4건뿐이라 뺐습니다.
- 모델은 앞선 실험과 같은 다섯 개입니다. 클로드 하이쿠 5.5, 하이쿠 4.5, 소넷 5.5, GPT-6 Luna, GPT-5.6 Luna.
2. 실험 설계
모델마다 그 회사의 에이전트 도구로 돌렸습니다. 클로드는 클로드 코드(claude -p), GPT는 코덱스(codex exec), 브라우저 작업은 두 회사 모델을 모두 연결할 수 있는 Aside 브라우저입니다.
- P대상
- 실제 업무 11가지: 시각 결과물 5, 글쓰기 3, 브라우저 작업 3
- I바꾼 것
- 모델 5개: Claude Haiku 5.5, Haiku 4.5, Sonnet 5.5, GPT-6 Luna, GPT-5.6 Luna
- C비교 기준
- GPT-6 Luna, 다섯 모델 중 가장 싼 모델
- O잰 것
- 기계 채점(100점), 사람 채점(5점, 시각 과제), 비용(API 환산 달러), 시간(초)
- T기간과 횟수
- 2026년 10월 8일, 과제마다 3회, 모두 165회
- 통제 못 한 것
- 사람 채점은 평가자 1명, 모델마다 실행 도구가 다름, 과제 문구는 클로드(Opus 5.5)가 씀
| 트랙 | 과제 | 기계 판정 |
|---|---|---|
| 시각 | 다이어그램(흐름도) | 노드와 연결선, 글자 겹침, 선이 글자를 지나가는지 |
| 시각 | 강의 슬라이드 5장 | 장 밖 넘침, 최소 글자 크기, 개조식 문장 |
| 시각 | 웹페이지 한 장 | 휴대폰 폭 가로 스크롤, 버튼 높이, 필수 요소 |
| 시각 | 데이터 차트 | 점 48개의 값, 값과 높이가 맞는지 |
| 시각 | 대외 문서(PDF) | 쪽수, 낱말 중간 줄바꿈, 원문에 없는 숫자 |
| 글쓰기 | Threads 글 | 글자 수, 링크 위치, 말투, 원문에 없는 숫자 |
| 글쓰기 | 블로그 초안 | 이 블로그의 발행 게이트 통과 여부 |
| 글쓰기 | 웹 리서치 | 공식 문서 값 5개와 출처 |
| 브라우저 | 검색, 쇼핑 비교, 예약 폼 | 정답 값과 제출된 값 대조 |
- 시각 과제는 실제 브라우저로 띄워 글자 하나하나의 위치와 크기를 쟀습니다.
- 비용은 Anthropic과 OpenAI 공식 가격표(10월 8일 확인)로 계산했습니다. 실험은 구독으로 돌려 실제 청구는 없었으니, 모든 비용은 API였다면 든 비용입니다.
3. 결과: 기계 채점과 사람 채점이 갈렸다
| 모델 | 규격 점수 | 만점 회차 | 사람 채점 점수 | 11과제 비용 | 11과제 시간 |
|---|---|---|---|---|---|
| Claude Haiku 5.5 | 100.0 | 33/33 | 3.8 | $0.117 | 365초 |
| Claude Sonnet 5.5 | 100.0 | 33/33 | 3.6 | $1.473 | 297초 |
| Claude Haiku 4.5 | 96.9 | 20/33 | 2.6 | $1.136 | 723초 |
| GPT-5.6 Luna | 96.7 | 23/33 | 3.8 | $0.125 | 334초 |
| GPT-6 Luna | 92.5 | 19/33 | 4.6 | $0.044 | 281초 |
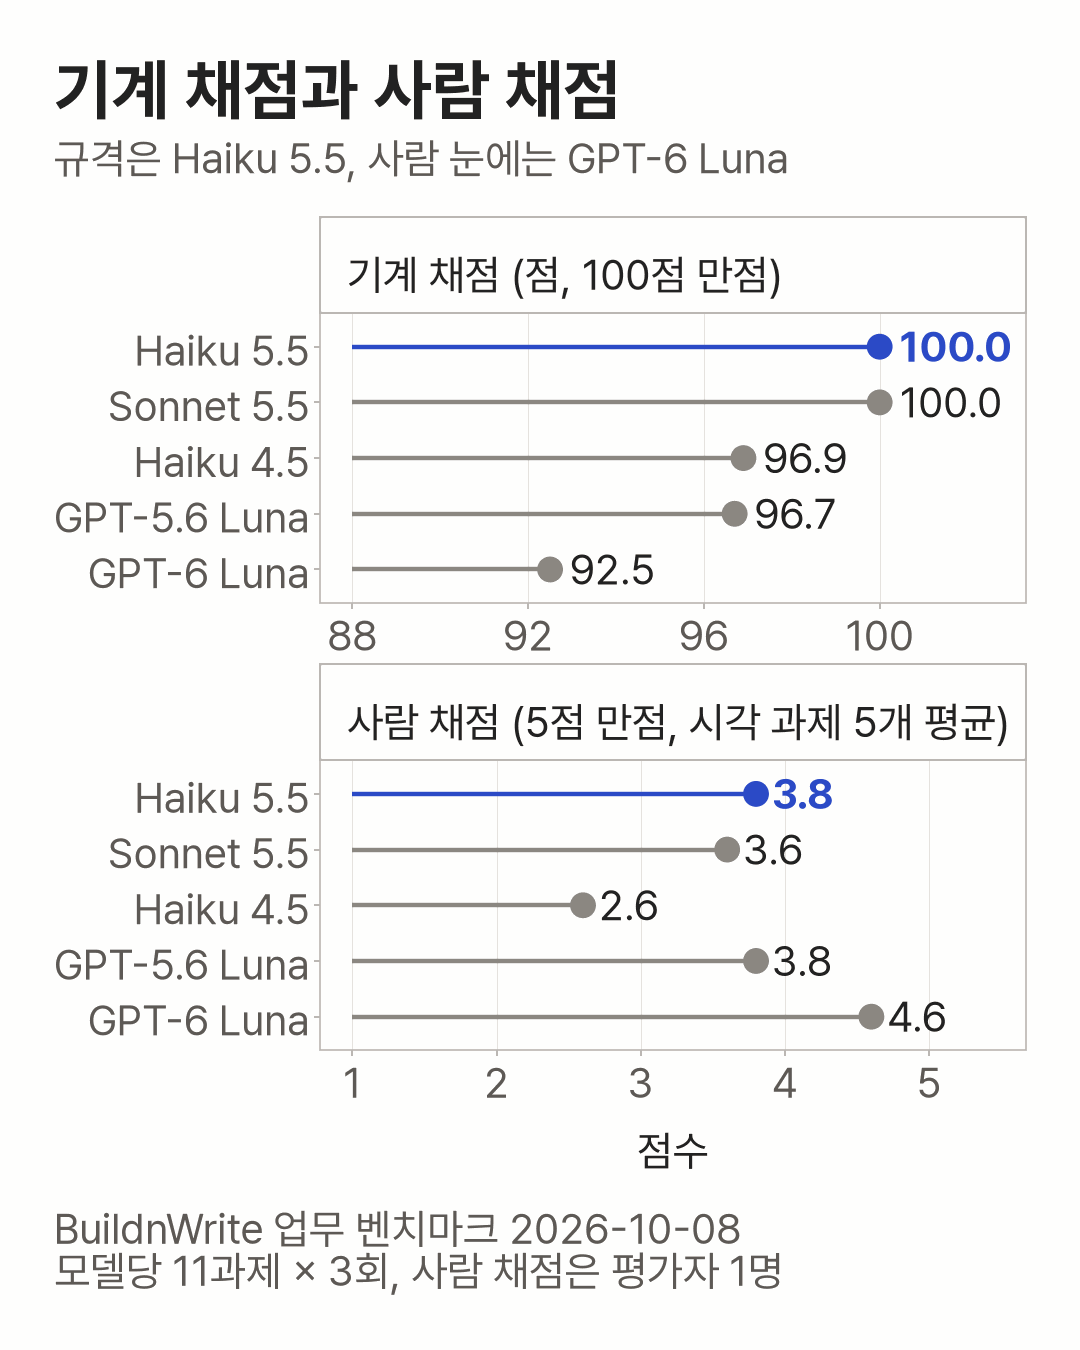
- 하이쿠 5.5와 소넷 5.5는 11과제 33번을 모두 규격대로 끝냈습니다.
- GPT-6 Luna는 규격을 가장 많이 어겼지만(33번 중 14번), 사람 채점 점수는 4.6으로 가장 높았습니다.
- 브라우저 작업만 보면 GPT-6 Luna를 뺀 네 모델이 9번 모두 만점이었습니다.
4. 어떤 상황에 무엇을 고르나
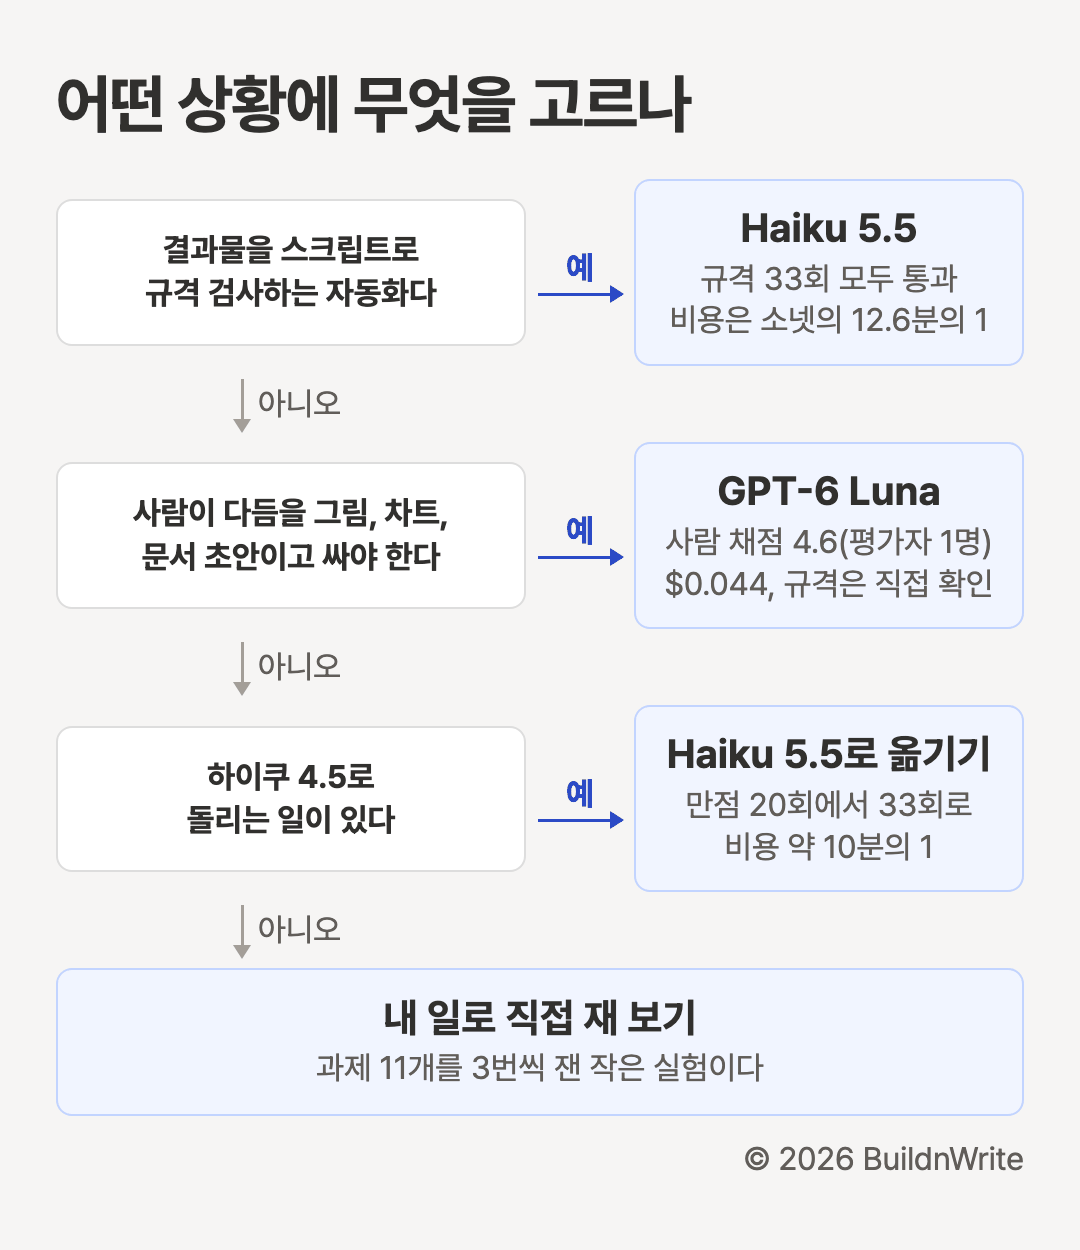
- 권하지 않는 경우: 시각 결과물에 하이쿠 4.5를 쓰는 것. 15번 중 4번만 규격을 통과했고 사람 채점 점수는 2.6이었습니다.
- 규격을 검사하는 자동화에서 소넷 5.5는 하이쿠 5.5와 규격 결과가 같고 비용만 약 12.6배였습니다.
- GPT-6 Luna는 글쓰기 과제(웹 리서치 포함)에서 다섯 모델 중 규격 점수가 가장 낮아, 글 초안에는 이 추천을 넓히지 않았습니다.
5. 결과물 나란히 보기
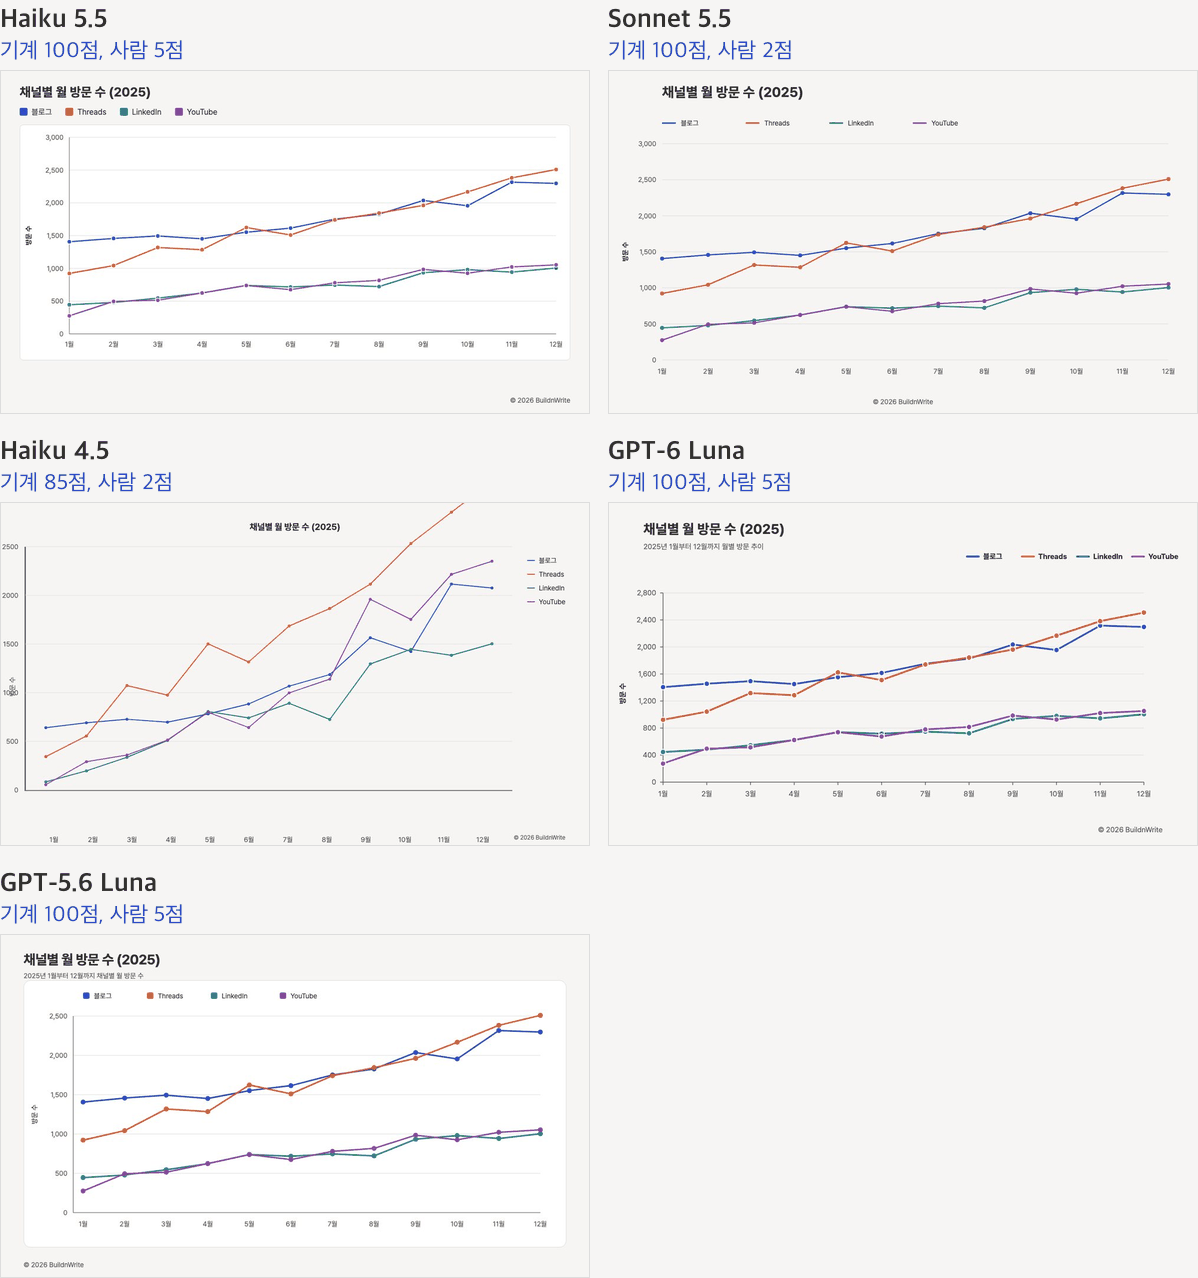
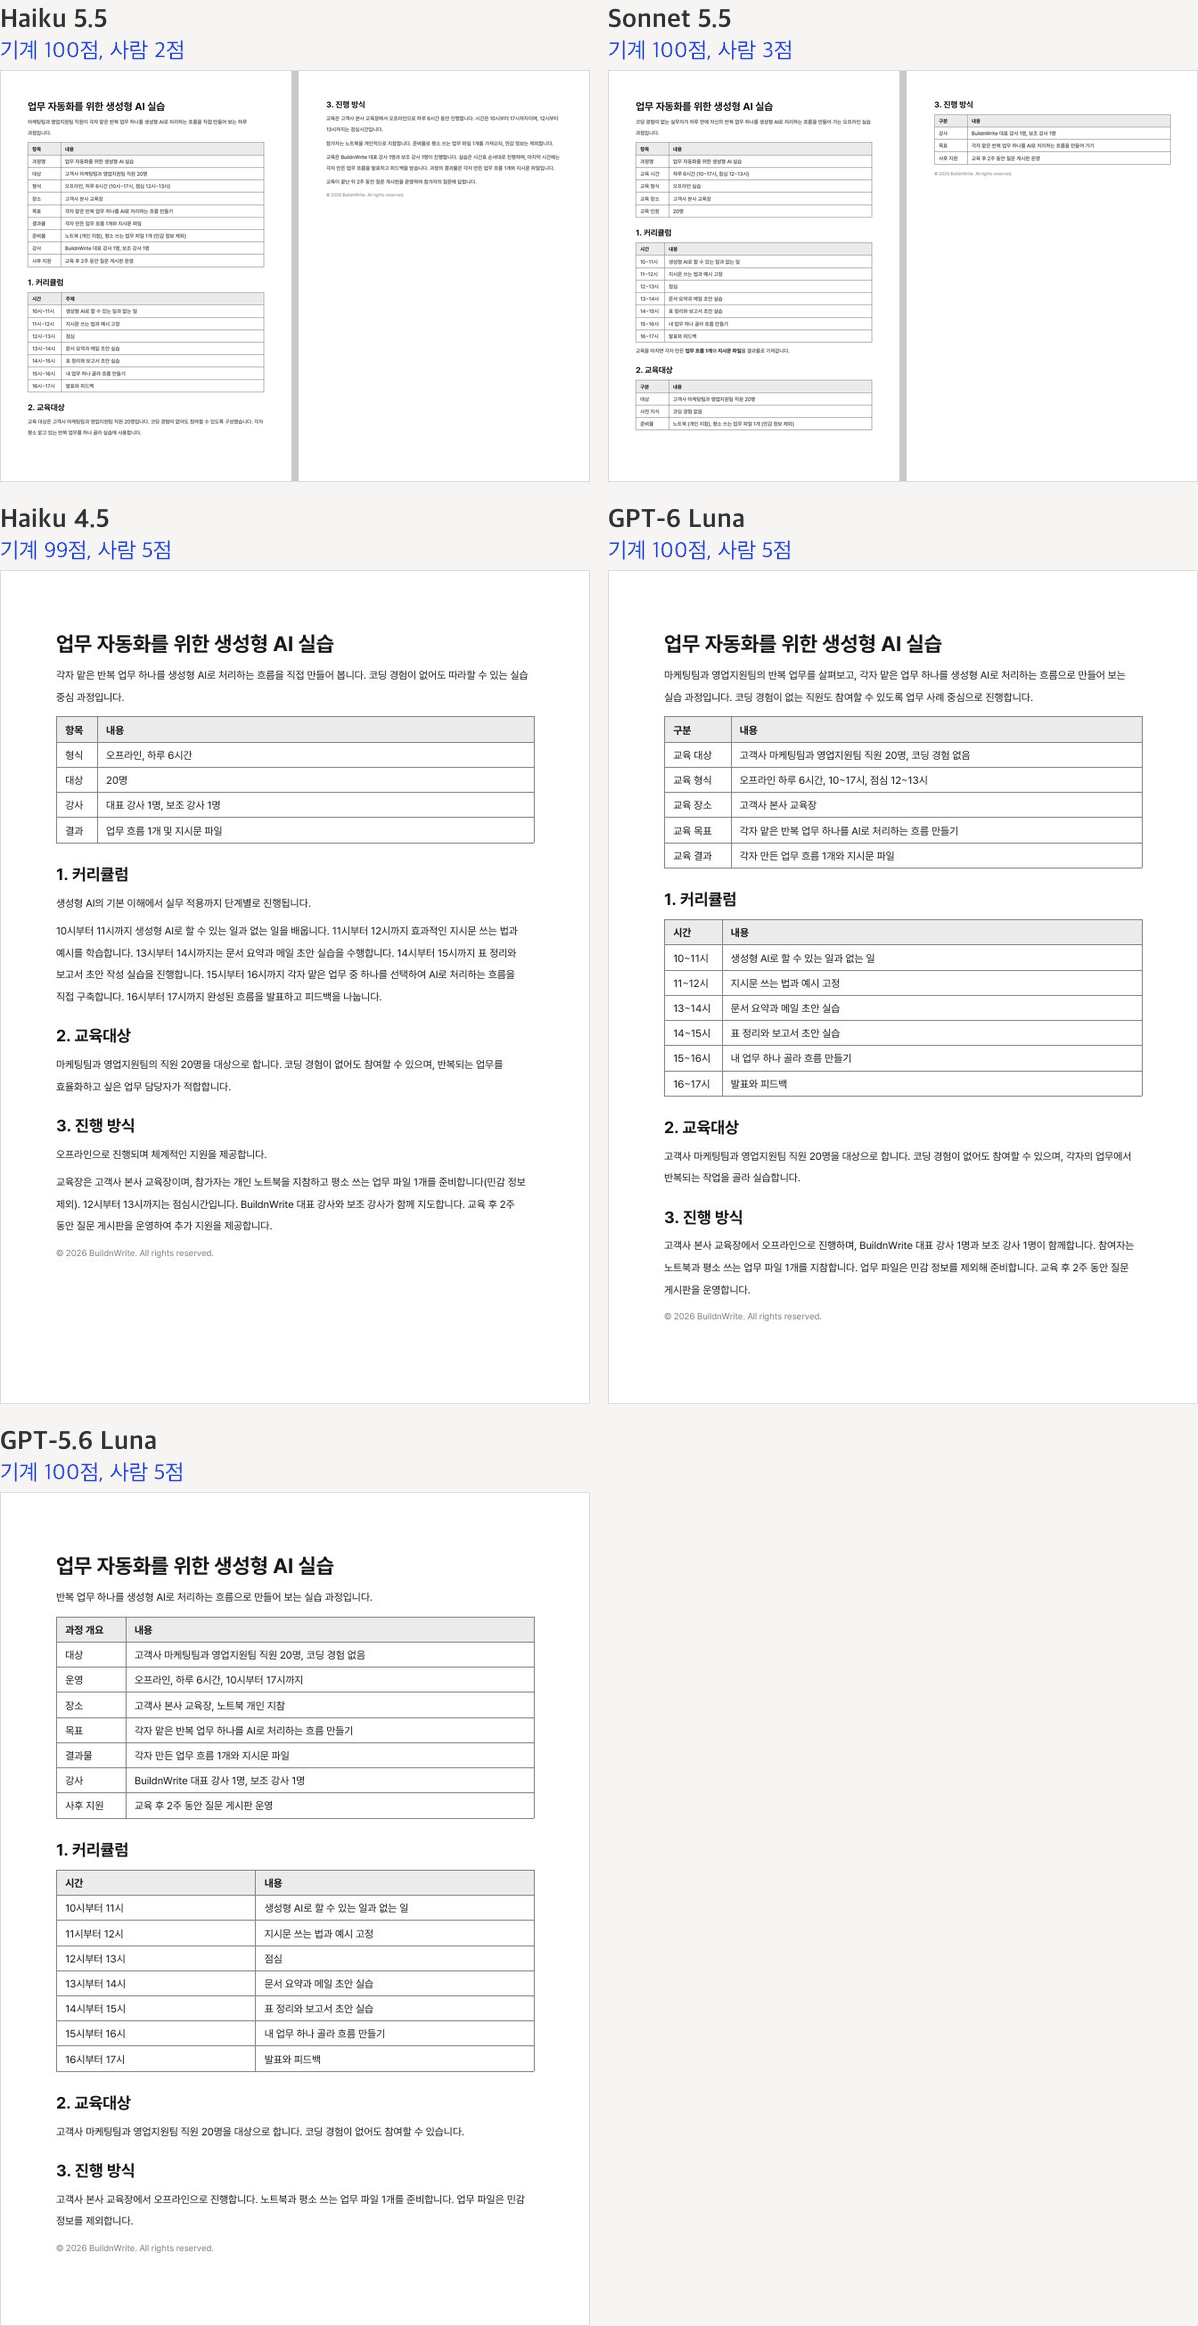
아래 그림은 1회차 결과물에 규격 점수와 사람 채점 점수를 함께 단 것입니다.
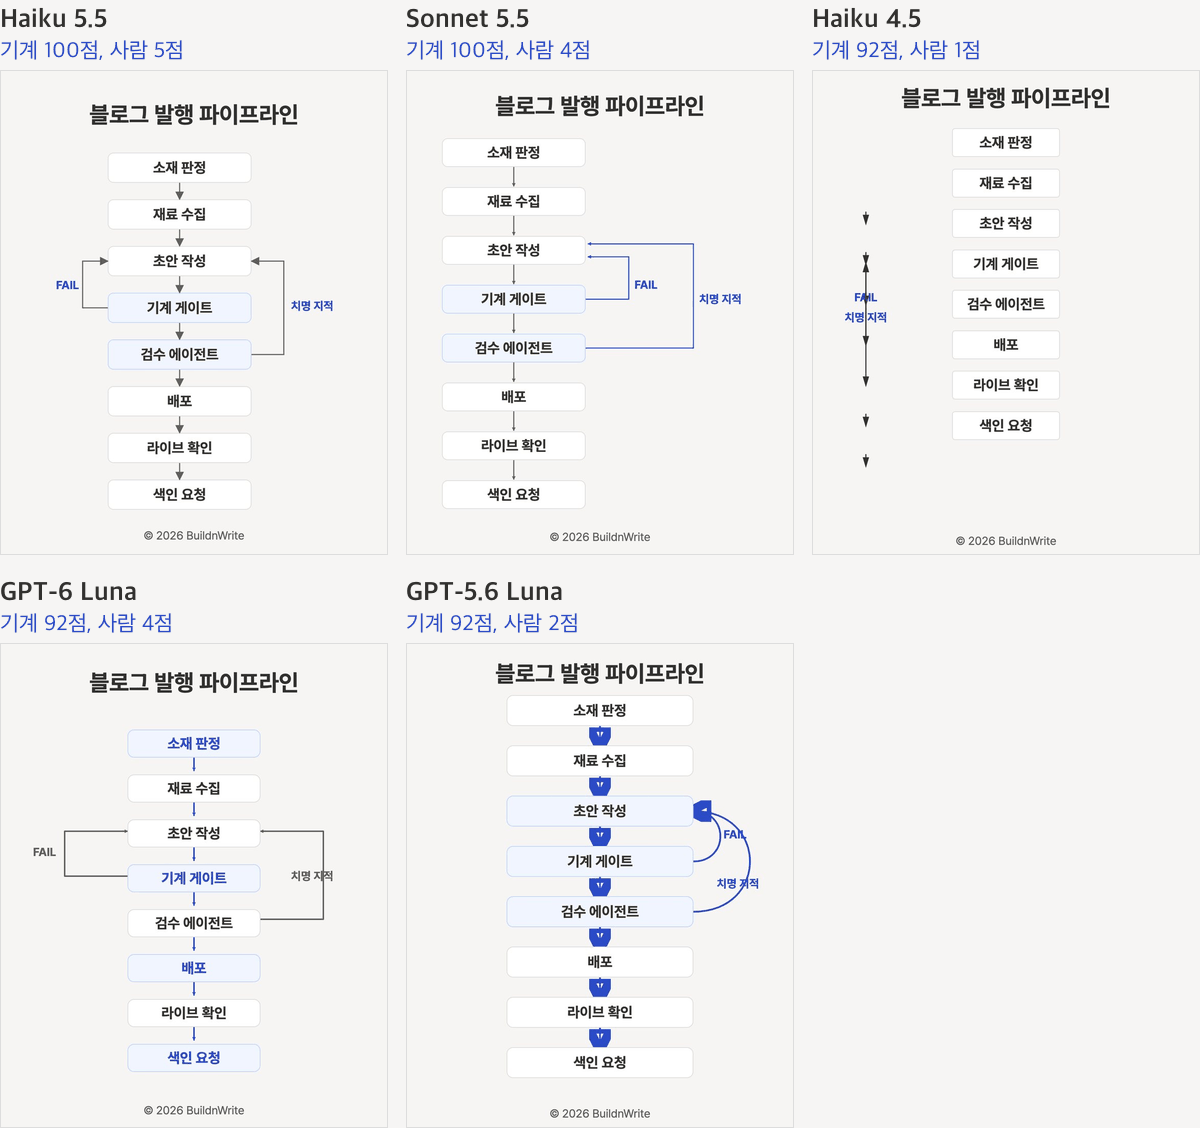
- 하이쿠 5.5의 흐름도는 규격과 사람 채점 점수 모두 만점이었습니다.
- 하이쿠 4.5의 흐름도는 화살표가 노드 왼쪽에 따로 흩어져 1점을 받았습니다. 연결선마다 어느 노드를 잇는지 표시는 달려 있어서, 기계 채점은 이 결함을 잡지 못했습니다.
6. 틀린 장면들
규격 점수가 깎인 자리는 모델마다 달랐습니다.
| 모델 | 주로 깎인 자리 (과제마다 실행 3번 중 감점된 횟수) |
|---|---|
| GPT-6 Luna | 흐름도 선이 글자를 지나감 3번, 웹 리서치 3번(빈칸 3개, 오답 2개), 쇼핑 비교 2번 |
| GPT-5.6 Luna | 흐름도 선이 글자를 지나감 2번, 슬라이드 글자 겹침 2번, 웹 리서치 3번(빈칸 2개, 오답 1개) |
| Claude Haiku 4.5 | 휴대폰 화면 14px 미만 글자 3번, 슬라이드 28px 미만 글자 2번, 흐름도 선 2번 |
웹 리서치에서 GPT-5.6 Luna의 출력 단가(공식 $1.20)를 GPT-6 Luna는 3번 중 2번, GPT-5.6 Luna 자신도 1번 $0.60으로 적었습니다.
"q2": {"answer": "0.60", "source_url": "https://developers.openai.com/api/docs/pricing"}(GPT-6 Luna, 웹 리서치 2회차 답 파일)
- 두 루나 모델은 “클로드 코드에서 하이쿠 5.5를 쓰려면 필요한 최소 버전”을 찾지 못했을 때 지어내지 않고 빈칸으로 남겼습니다. 지시대로입니다.
- 쇼핑 비교의 GPT-6 Luna 오답 2번은 앞선 Aside 실험에서 틀린 것과 같은 과제였습니다.
7. 비용, 시간, 성능
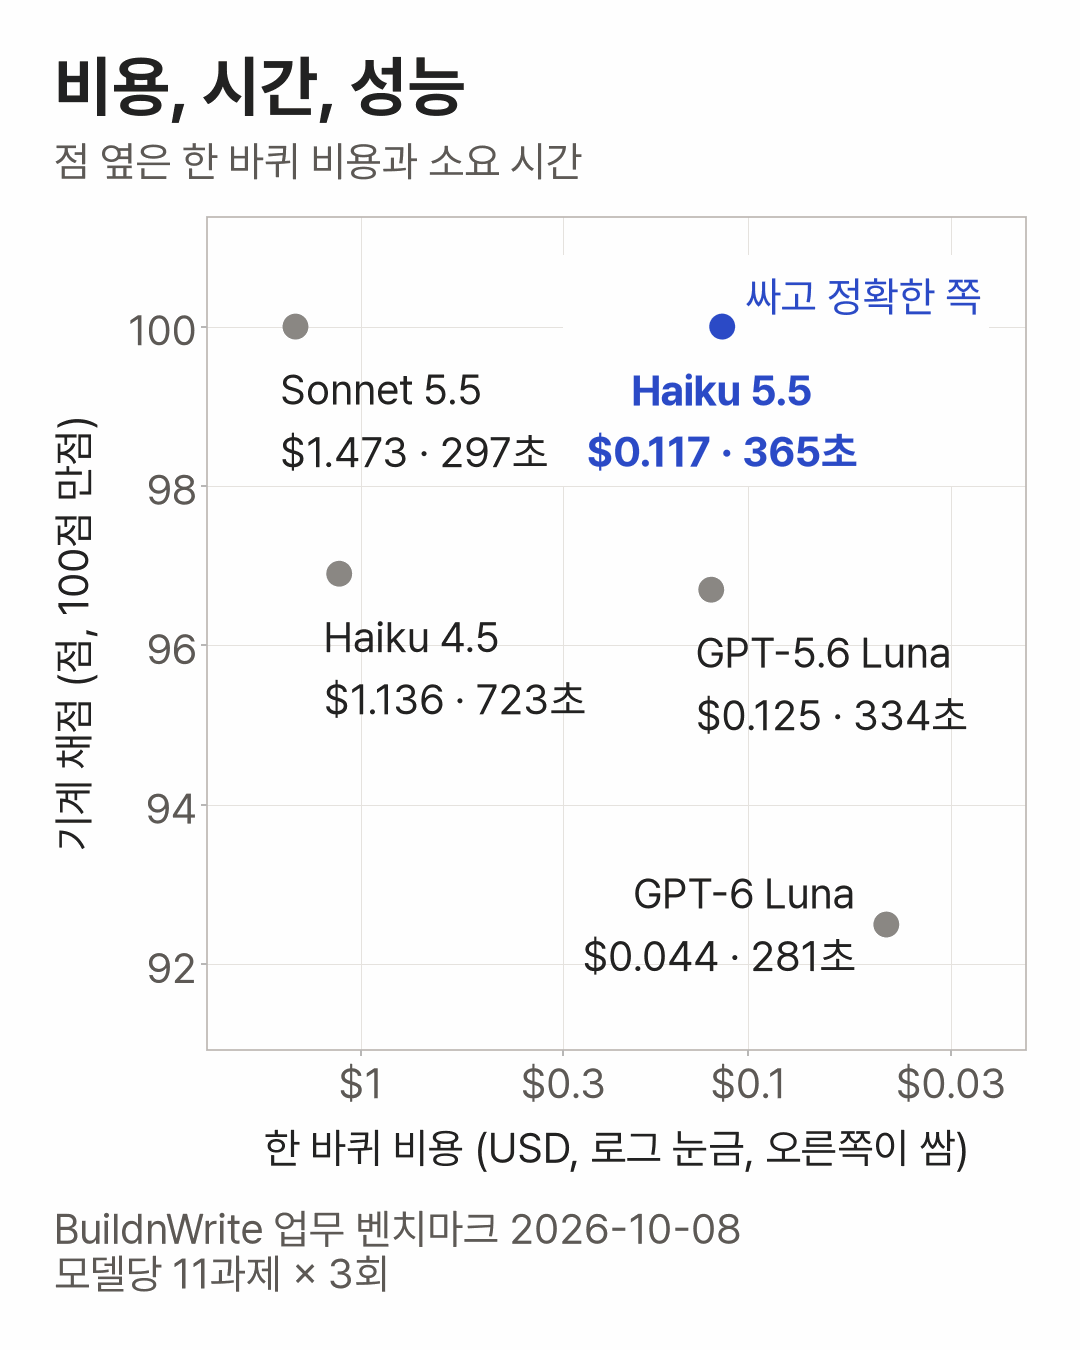
- 하이쿠 4.5는 하이쿠 5.5보다 약 10배 비쌌습니다. 입력, 캐시, 출력 단가가 모두 하이쿠 5.5의 10배입니다.
- 시간은 GPT-6 Luna(281초)와 소넷 5.5(297초)가 가장 짧았고, 하이쿠 4.5(723초)가 가장 길었습니다.
- 소넷 5.5의 차트 2회차 한 번은 실행 도중 도구가 멈췄다가 다시 시작되어 비용 기록이 빠졌습니다. 그 한 번은 다시 돌린 값으로 바꿨습니다.
8. 이 실험의 한계
- 사람 채점 점수는 평가자 1명이 시각 과제마다 1회차 결과물 한 벌씩만 봤습니다. 모델마다 점수 5개라, GPT-6 Luna 4.6과 하이쿠 5.5 3.8의 차이도 합계 4점 차이입니다. 글쓰기와 브라우저 과제에는 사람 채점 점수가 없습니다.
- 기계 채점은 규격만 잽니다. 하이쿠 4.5의 흐름도처럼 연결 표시는 맞는데 화살표가 떨어져 있는 결함은 놓쳤습니다.
- 채점기를 검산하다 버그 두 개를 고치고 다시 채점했습니다. 웹 검색 답의 첫 숫자만 보던 것과, 문서 과제의 “2쪽 이내”를 “정확히 2쪽”으로 판정하던 것입니다.
- 모델과 실행 도구를 묶어 쟀습니다. 같은 모델을 API로 직접 부르면 결과와 비용이 달라질 수 있고, 이번에는 재지 않았습니다.
- 추론 강도는 medium 하나로만 쟀습니다. 두 회사의 medium이 같은 수준이라는 보장은 없습니다.
9. 정리
- 같은 모델이라도 “규격을 지켰나”와 “보기 좋은가”는 다른 결과를 냈습니다. 둘 다 재야 고를 수 있습니다.
- 하이쿠 4.5를 쓰고 있다면 하이쿠 5.5로 옮겨 규격 통과와 비용을 함께 개선할 수 있었습니다.
자주 묻는 질문
- AI 업무 자동화에는 GPT 루나와 클로드 하이쿠 중 무엇이 낫나요?
- 실제 업무 11가지를 3번씩 맡긴 이 실험에서, 정해 둔 규격을 지켰는지는 Claude Haiku 5.5가 33번 모두 통과했고 GPT-6 Luna는 19번 통과했습니다. 반대로 시각 과제 5개를 모델 이름을 가리고 매긴 사람 채점 점수(5점 만점, 평가자 1명)는 GPT-6 Luna가 4.6으로 가장 높고 Haiku 5.5는 3.8이었습니다. 비용은 11과제 한 바퀴에 GPT-6 Luna 0.044달러, Haiku 5.5 0.117달러였습니다(2026년 10월 8일 실측).
- 클로드 하이쿠 5.5와 소넷 5.5는 업무 결과가 얼마나 다른가요?
- 이 실험에서는 두 모델 모두 11과제 33번을 전부 규격대로 끝냈습니다. 비용은 한 바퀴에 하이쿠 5.5가 0.117달러, 소넷 5.5가 1.473달러로 하이쿠 5.5가 약 12.6분의 1이었습니다.
댓글