GPT 루나 vs 클로드 하이쿠 5.5, 업무 과제 6개로 비교한 결과
이 글의 독자요약, 분류, 채점처럼 반복되는 업무를 싼 AI 모델에 맡기려는데, 새로 나온 하이쿠 5.5와 GPT 루나 중 무엇이 내 일에 맞는지 숫자로 보고 싶은 직장인과 1인 사업자
한줄 요약: GPT 루나 두 모델과 클로드 하이쿠 5.5, 하이쿠 4.5, 소넷 5.5에 같은 업무 과제 6개를 3번씩 맡겼습니다. 추출, 분류, 표 분석, 코드 수정은 다섯 모델 모두 만점이었고, 점수 차이는 대부분 자기소개서 채점에서 났습니다. 정답이 정해진 일이면 가장 싼 GPT-6 Luna나 하이쿠 5.5로 충분했고, 채점 과제에서 출제 의도와 가장 많이 맞은 모델은 소넷 5.5였습니다. 이 실험 조건에서 하이쿠 4.5를 하이쿠 5.5로 바꾸면 비용이 약 10분의 1로 줄었습니다.
목차
- 공식 벤치마크와 내 업무는 다르다
- 실험 설계
- 결과: 네 과제는 모두 만점
- 어떤 상황에 무엇을 고르나
- 차이가 난 곳: 자기소개서 채점
- 규칙 글쓰기에서 나온 실수
- 비용과 시간
- 이 실험의 한계
- 정리
1. 공식 벤치마크와 내 업무는 다르다
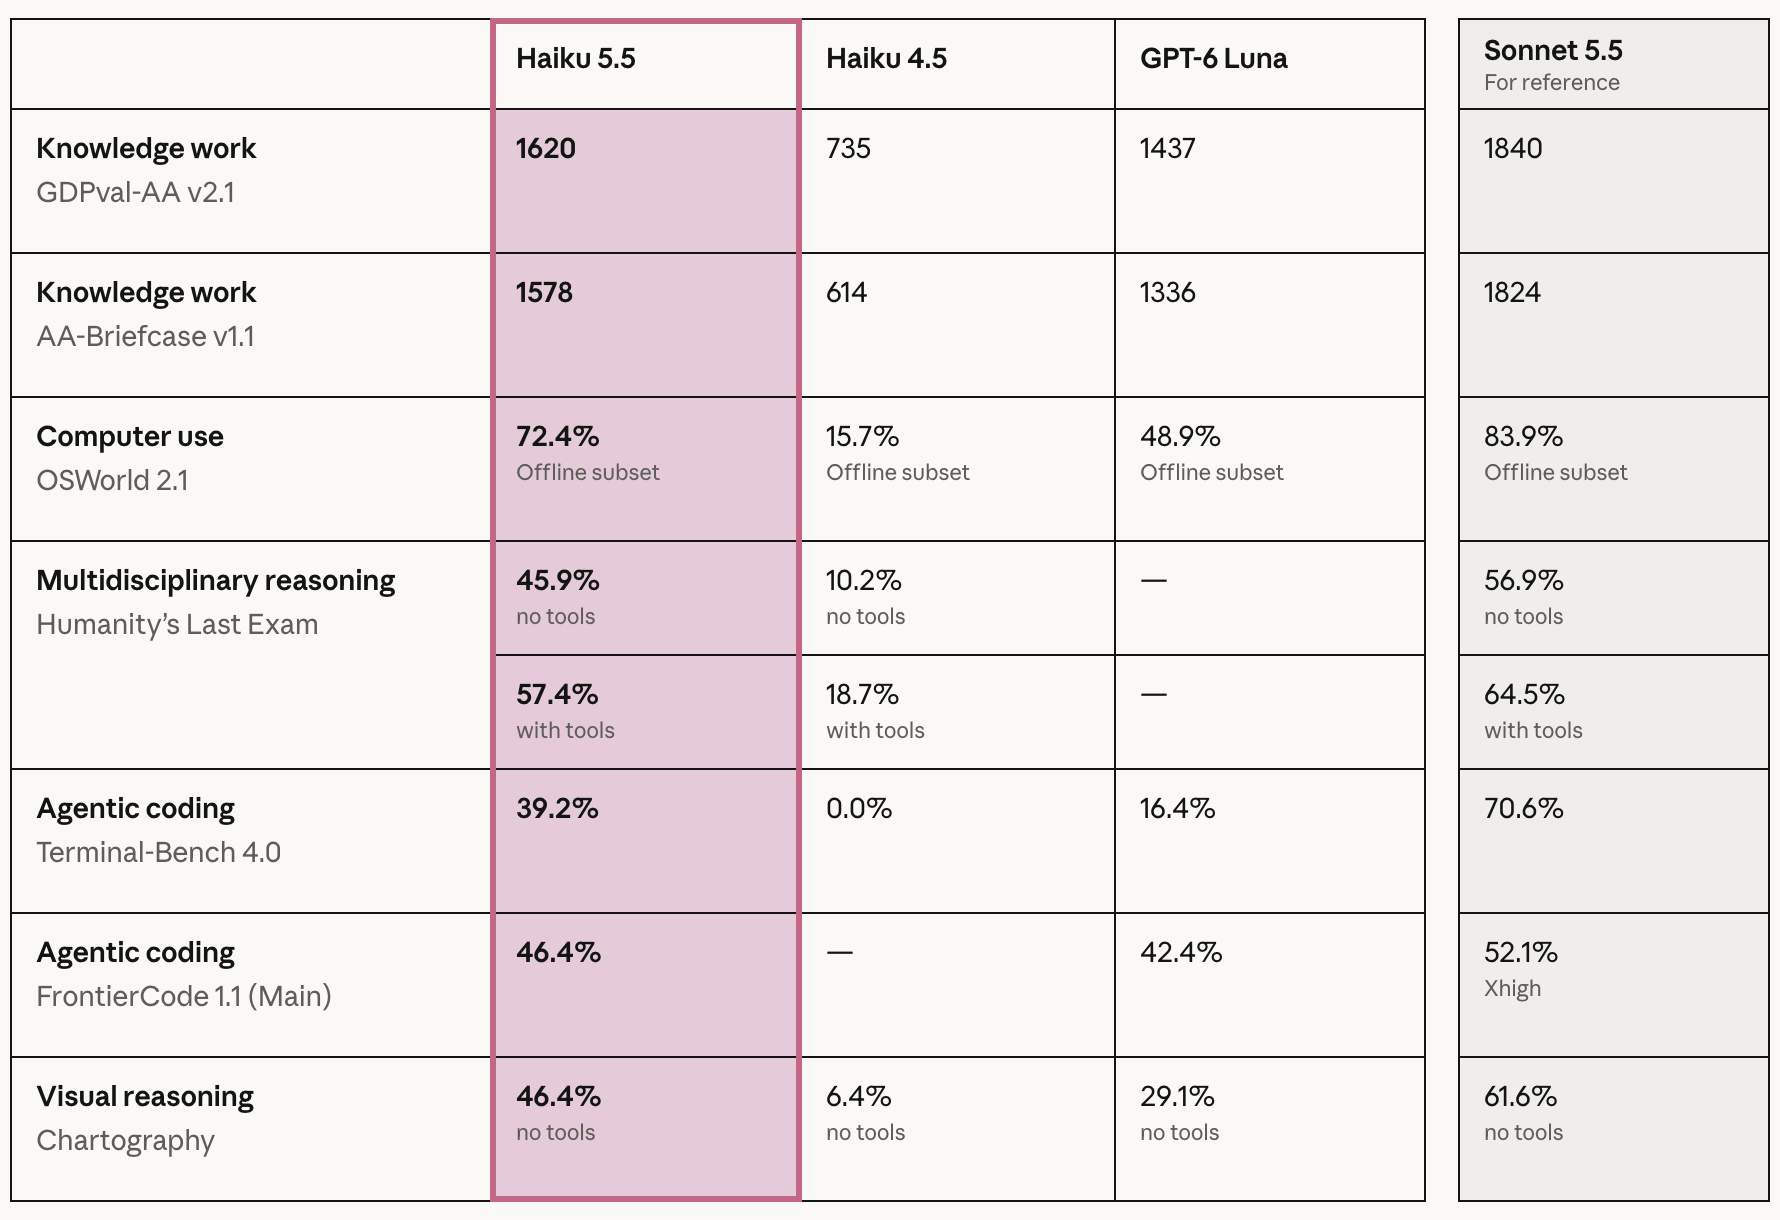
2026년 10월 7일 Anthropic이 클로드 하이쿠 5.5를 발표하면서 비교 상대로 OpenAI의 GPT-6 Luna를 골랐습니다. 발표 표에서 하이쿠 5.5는 점수가 공개된 모든 항목에서 GPT-6 Luna보다 높았습니다. 발표 내용과 가격은 하이쿠 5.5 출시 정리 글에 따로 정리했습니다.
공식 벤치마크는 범용 능력을 잽니다. 반복 업무를 싼 모델에 맡기려는 사람에게 필요한 질문은 다릅니다.
- 내가 매일 하는 종류의 일에서도 그 순위가 유지되는가
- 그 일 한 번에 실제로 얼마가 들고, 얼마나 걸리는가
그래서 1인 교육, 콘텐츠 회사가 실제로 반복하는 일 6가지를 과제로 고정하고, 새 모델이 나올 때마다 같은 과제로 다시 재는 BuildnWrite 업무 표준 벤치마크를 만들었습니다. 이 글은 그 첫 회차입니다.
2. 실험 설계
비교 단위는 모델 단독이 아니라 모델과 그 회사의 에이전트 도구입니다. 클로드 모델은 클로드 코드(claude -p)로, GPT 모델은 코덱스(codex exec)로 돌렸습니다. 둘 다 사람이 지켜보지 않고 한 번에 일을 끝내는 방식이라, 반복 업무를 맡기는 실제 모습과 같습니다.
- 정확도: 채점 스크립트가 정답과 대조한 점수(100점 만점)
- 소요 시간 초: 실행 시작부터 도구가 끝날 때까지
- 비용 USD: 도구가 남긴 토큰 수에 공식 API 단가를 곱한 값
과제 자료는 모두 합성 자료라 실제 고객 정보는 없습니다.
| 과제 | 하는 일 | 정답 판정 |
|---|---|---|
| 추출 | 가상 제품 발표문에서 가격, 날짜, 사양 17칸 뽑기 | 칸별 정확 일치. 발표문에 없는 값은 비워 두는 것이 정답 |
| 분류 | 문의 메일 30건을 강의, 컨설팅 등 6분류로 나누기 | 정답 일치율 |
| 채점 | 자기소개서 30건을 채점표로 1점부터 5점까지 매기기 | 글을 쓰기 전에 정해 둔 등급과 일치율 |
| 표 분석 | 중복 행과 쉼표 숫자가 섞인 성과표에서 8개 질문 답하기 | 숫자 정확 일치 |
| 규칙 글쓰기 | 블로그 문단을 Threads 글로, 규칙 10개 지키며 | 글자 수, 금지어, 원문 복사 등 10개 기계 검사 |
| 코드 수정 | 버그 3개 있는 UTM 링크 생성기 고치기 | 숨은 테스트 8개 통과율 |
비용은 두 회사 공식 가격표(Anthropic, OpenAI, 10월 8일 확인)로 계산했습니다. 실험은 구독으로 돌려 실제 청구는 없었으니, 아래 비용은 모두 API였다면 든 비용입니다.
3. 결과: 네 과제는 모두 만점
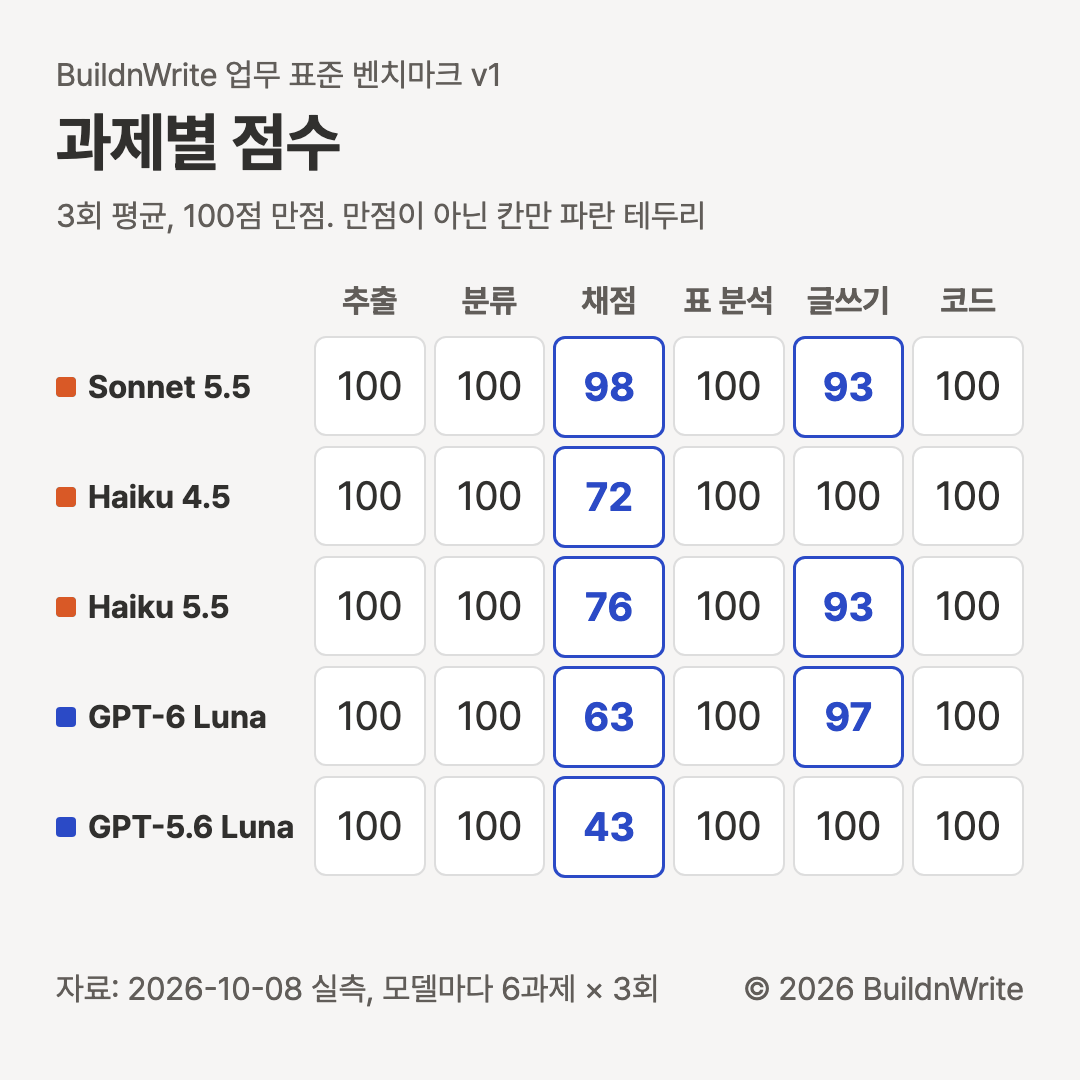
| 모델 | 평균 점수 | 회차별 범위 | 6과제 비용 | 6과제 시간 |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 98.5 | 97.8에서 99.5 | $0.390 | 119초 |
| Claude Haiku 4.5 | 95.4 | 92.8에서 99.5 | $0.479 | 383초 |
| Claude Haiku 5.5 | 94.8 | 93.9에서 95.6 | $0.050 | 214초 |
| GPT-6 Luna | 93.3 | 92.8에서 94.5 | $0.013 | 98초 |
| GPT-5.6 Luna | 90.5 | 90.5 (3회 같음) | $0.045 | 135초 |
- 평균 점수 차이는 대부분 채점 과제에서 나왔고, 규칙 글쓰기의 실수가 일부를 더했습니다. 하이쿠 5.5는 채점에서 하이쿠 4.5보다 높았지만(75.6 대 72.2) 글쓰기 실수 2회 때문에 평균은 하이쿠 4.5보다 낮았습니다.
- 하이쿠 5.5와 GPT-6 Luna, 하이쿠 5.5와 하이쿠 4.5는 회차별 범위가 겹칩니다. 이 표본으로는 둘 사이에 우열을 말할 수 없습니다.
- 비교적 분명한 것은 둘입니다. 채점 과제를 90건 합계로 보면 소넷 5.5가 88건을 맞혀 가장 많았고(다음은 하이쿠 5.5 68건), GPT-5.6 Luna는 채점에서 세 번 모두 43점이었습니다. 다만 하이쿠 4.5도 채점 3회차에 30건 중 29건을 맞혀, 회차 하나씩 보면 소넷과 범위가 닿습니다.
4. 어떤 상황에 무엇을 고르나
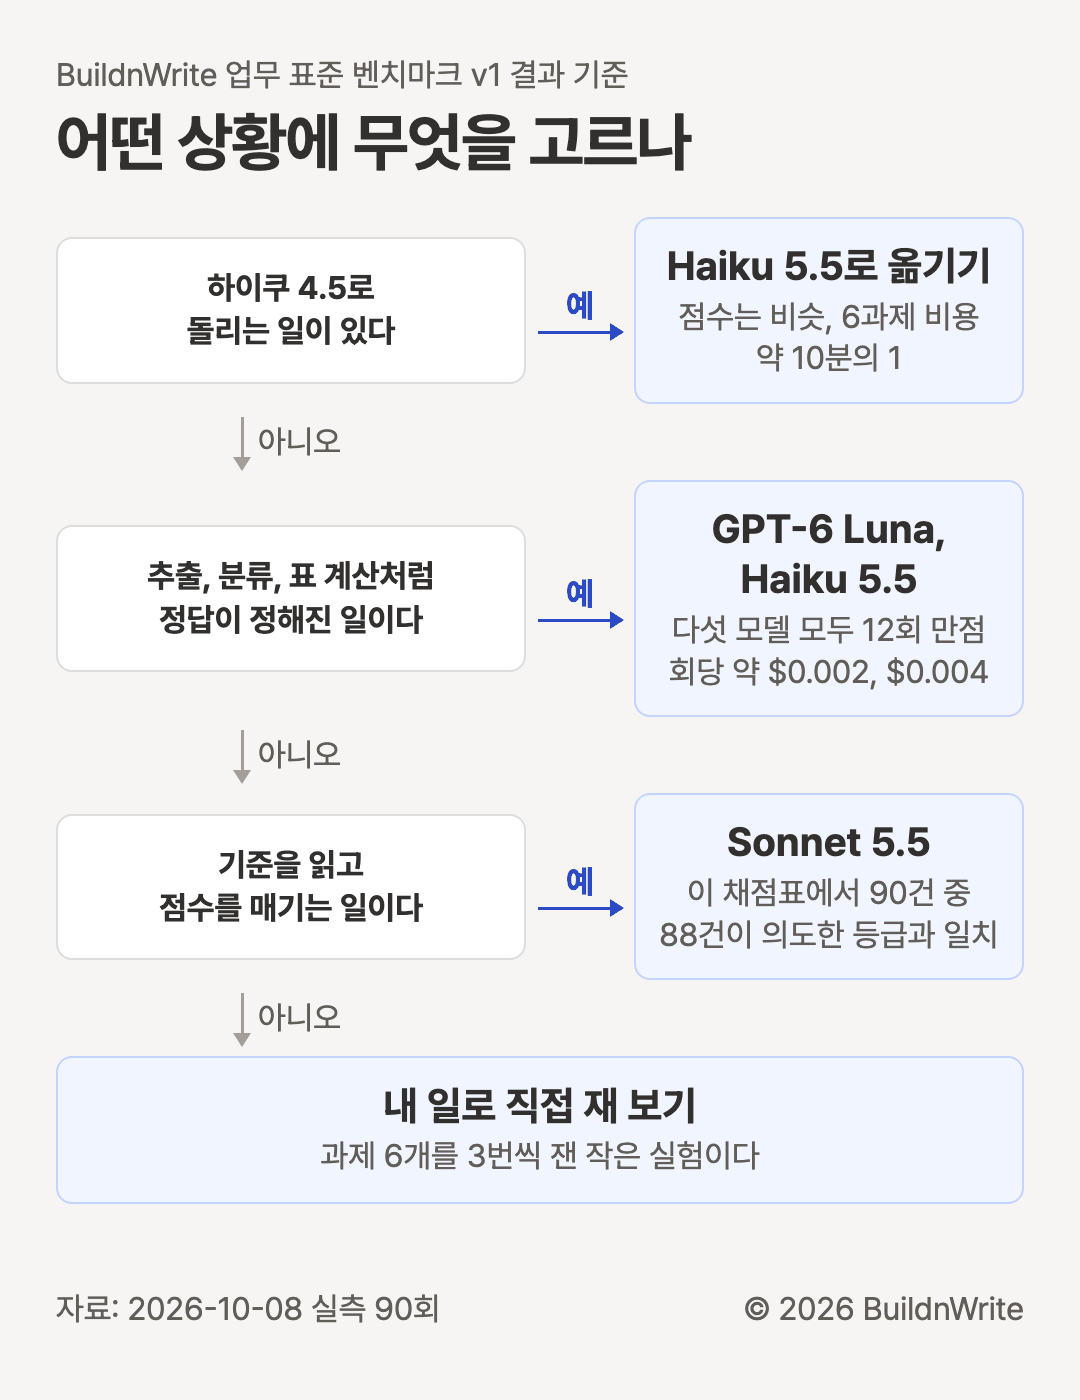
- 권하지 않는 경우: 이 채점표로 채점을 맡길 때 GPT-5.6 Luna는 3회 모두 43점이었습니다.
- 소넷 5.5 칸은 채점표 하나, 과제 하나의 결과입니다. 다른 기준표에서는 결과가 다를 수 있습니다.
5. 차이가 난 곳: 자기소개서 채점
채점 과제는 합성 자기소개서 30건(1등급부터 5등급까지 각 6건)에 채점표를 주고 항목별 점수를 매기게 했습니다. 등급은 글을 쓰기 전에 정해 두었습니다. 채점표에는 “인접한 두 점수 중 무엇을 줄지 아래 기준으로 판별하세요. 조건을 만족하면 높은 쪽을 줍니다.“라는 지시가 들어 있습니다.
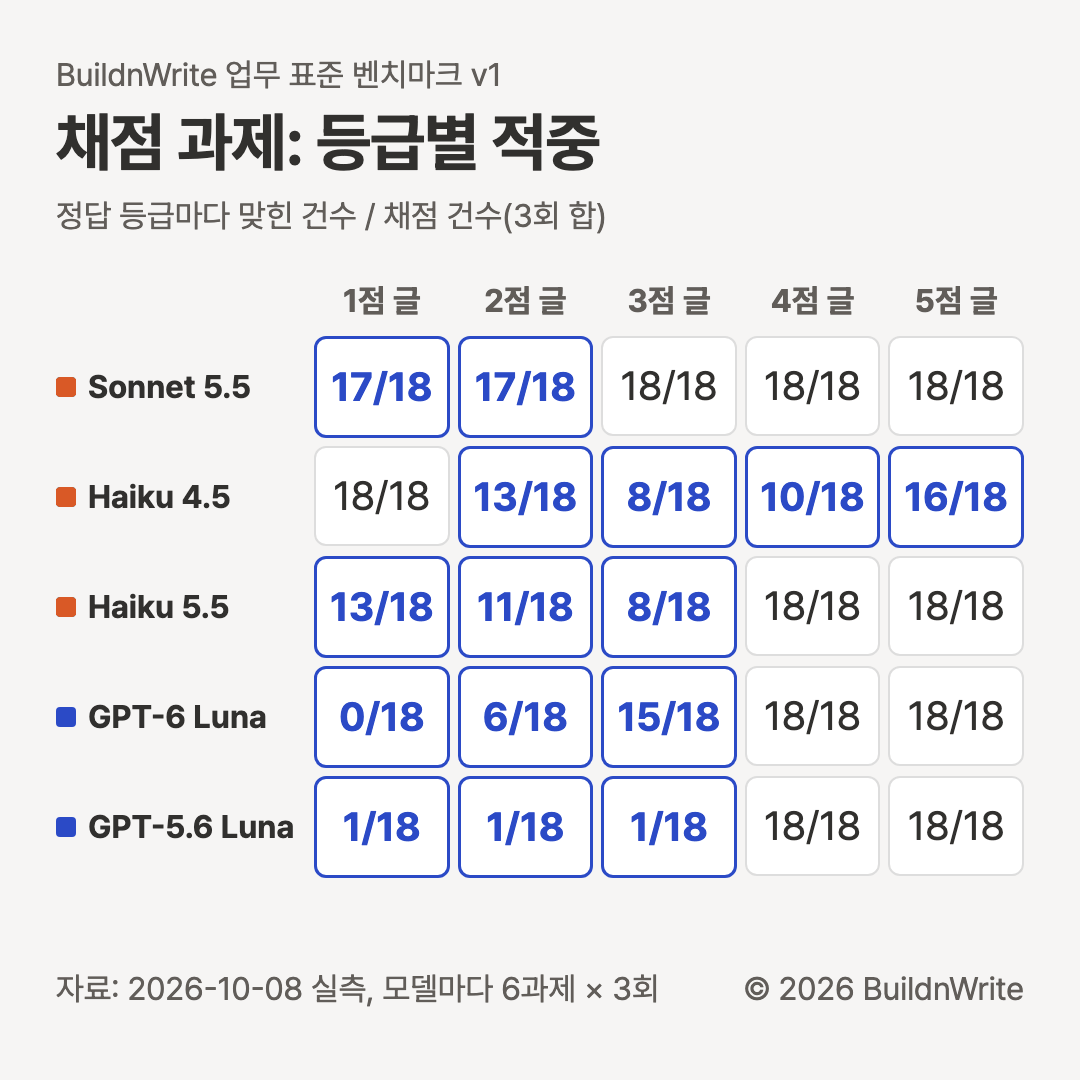
틀린 방향이 모델마다 달랐습니다.
| 모델 | 정답보다 높게 (90건 중) | 정답보다 낮게 (90건 중) |
|---|---|---|
| Sonnet 5.5 | 2 | 0 |
| Haiku 5.5 | 22 | 0 |
| Haiku 4.5 | 0 | 25 |
| GPT-6 Luna | 33 | 0 |
| GPT-5.6 Luna | 51 | 0 |
- GPT-5.6 Luna는 1등급부터 3등급까지의 글 54건 중 51건을 높게 줬고, 그중 2건은 두 단계 높았습니다.
- GPT-6 Luna는 1등급 글 18건을 모두, 2등급 글은 12건을 높게 줬습니다. 3등급 글은 18건 중 15건을 맞혔습니다.
- 하이쿠 4.5는 반대로 낮게 줬습니다. 3등급 글 10건, 4등급 글 8건으로 절반 안팎이고, 3회차에는 29건을 맞혀 회차마다 흔들림이 컸습니다.
- 4등급과 5등급 글은 하이쿠 4.5를 뺀 네 모델이 모두 맞혔습니다.
정답이 1등급인 글 하나를 보면 루나의 점수도 채점표 문구로는 말이 됩니다.
열심히 하겠습니다. 뽑아주시면 감사하겠습니다.
(합성 자기소개서 E01의 지원동기 답, 정답 등급 1)
채점표의 2점 기준은 “문항이 묻는 것에 답의 방향은 맞다. 짧아도 답하고 있으면 2점이다.“이고, 1점 기준은 “문항과 무관하거나 답을 회피한다”입니다. 이 답에 루나 두 모델은 3회 모두 2점을, 소넷 5.5는 3회 모두 1점을 줬습니다. 하이쿠 5.5는 3회 중 2회 1점이었습니다. 그래서 이 과제가 재는 것은 채점 능력 그 자체가 아니라 채점표를 쓴 사람이 의도한 등급과 얼마나 맞는가입니다. 사람이 만든 기준으로 대량 채점을 맡길 때 실제로 필요한 것이 이 일치도입니다.
6. 규칙 글쓰기에서 나온 실수
규칙 글쓰기는 15회 중 다섯 모델이 대부분 10개 규칙을 다 지켰습니다. 만점이 아닌 5회는 모두 한 규칙씩만 어겼고, 실수의 종류는 두 가지였습니다.
- 원문 문장을 20자 이상 그대로 옮김: 하이쿠 5.5 2회, 소넷 5.5 2회
- 금지어 “여러분”을 씀: GPT-6 Luna 1회
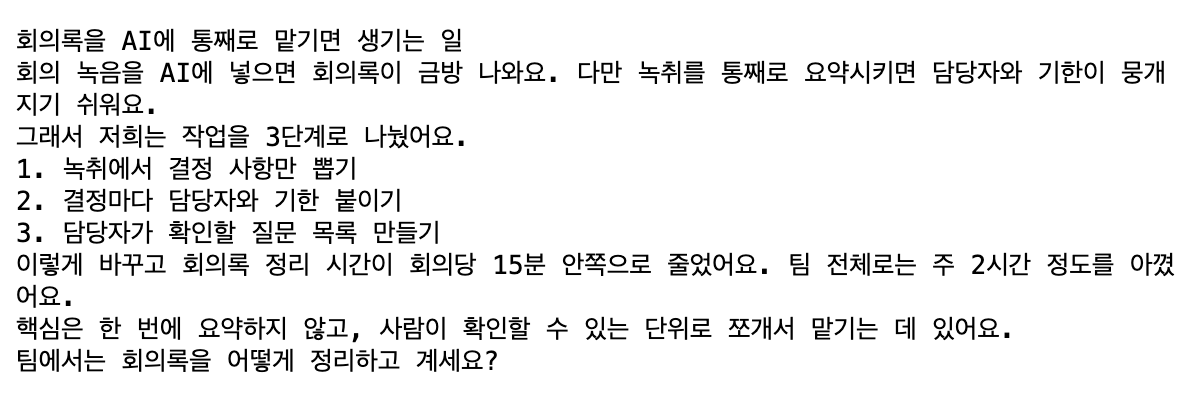
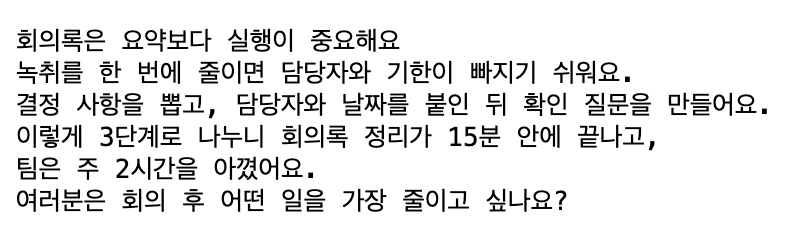
같은 원문, 같은 규칙에서 나온 글의 길이와 구성은 모델마다 달랐습니다. 소넷 5.5의 1회차 글 앞부분입니다.
회의록 AI, 요약만 시키면 흐려져요 녹취를 통째로 요약시키면 누가 뭘 언제까지 하는지 사라져요. 그래서 작업을 3단계로 쪼갰어요.
(Claude Sonnet 5.5, 규칙 글쓰기 1회차 산출물)
글의 재미나 설득력은 기계로 잴 수 없어 점수에 넣지 않았습니다. 이 점수는 규칙을 지켰는지만 말합니다.
7. 비용과 시간
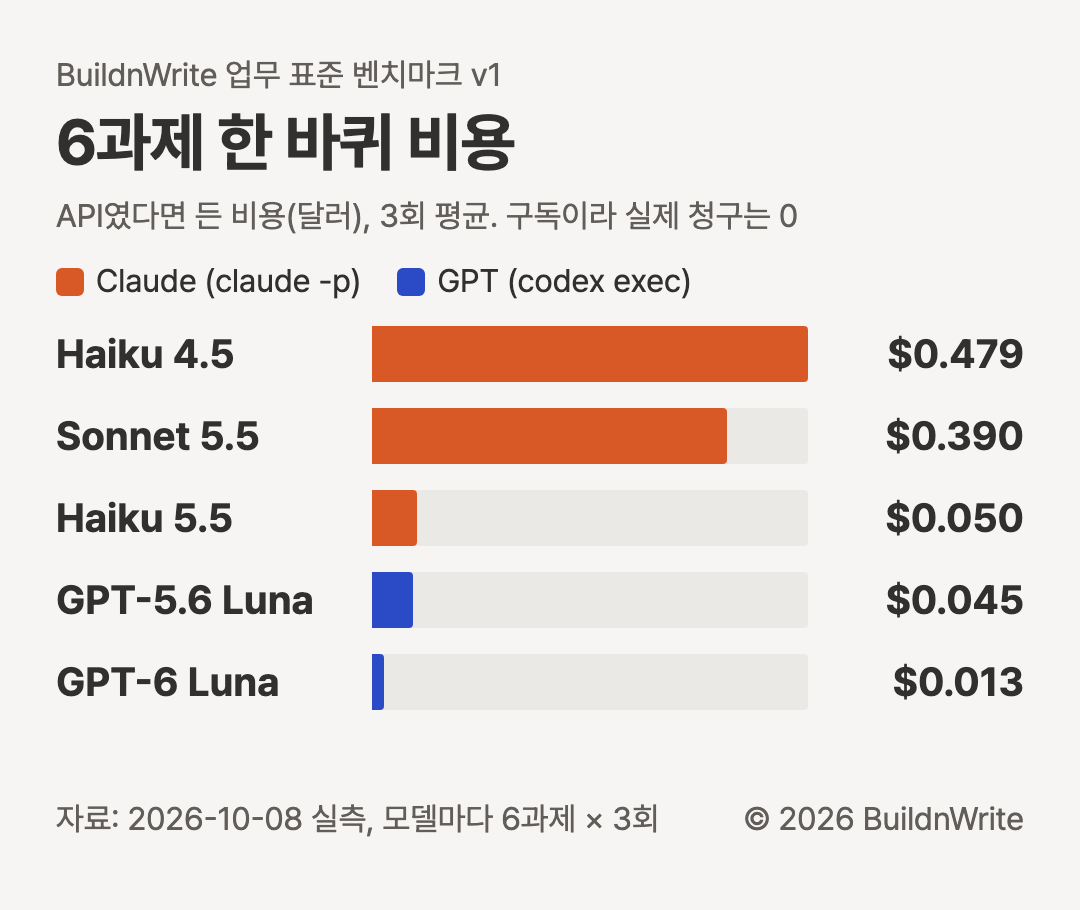
- 하이쿠 5.5는 하이쿠 4.5보다 한 바퀴 비용이 약 90% 쌌습니다($0.479에서 $0.050). 발표가 밝힌 평균 약 75% 인하보다 큰 폭이고, 이번 과제의 요청은 모두 할인 폭이 큰 10만 토큰 이하 구간에 들었습니다.
- 하이쿠 4.5가 소넷 5.5보다 비싼 이유는 출력 길이입니다. 한 바퀴 출력이 약 4만 토큰(그중 생각 약 3만 1천)으로 소넷 5.5(약 6천 9백)의 6배 가까이 됐고, 캐시 읽기 단가는 두 모델이 $0.10으로 같습니다.
- GPT-6 Luna는 하이쿠 5.5의 약 4분의 1 비용이었습니다. 클로드 코드의 기본 지시문(약 2만 9천 토큰)이 매번 붙는 것도 이 차이에 들어 있습니다.
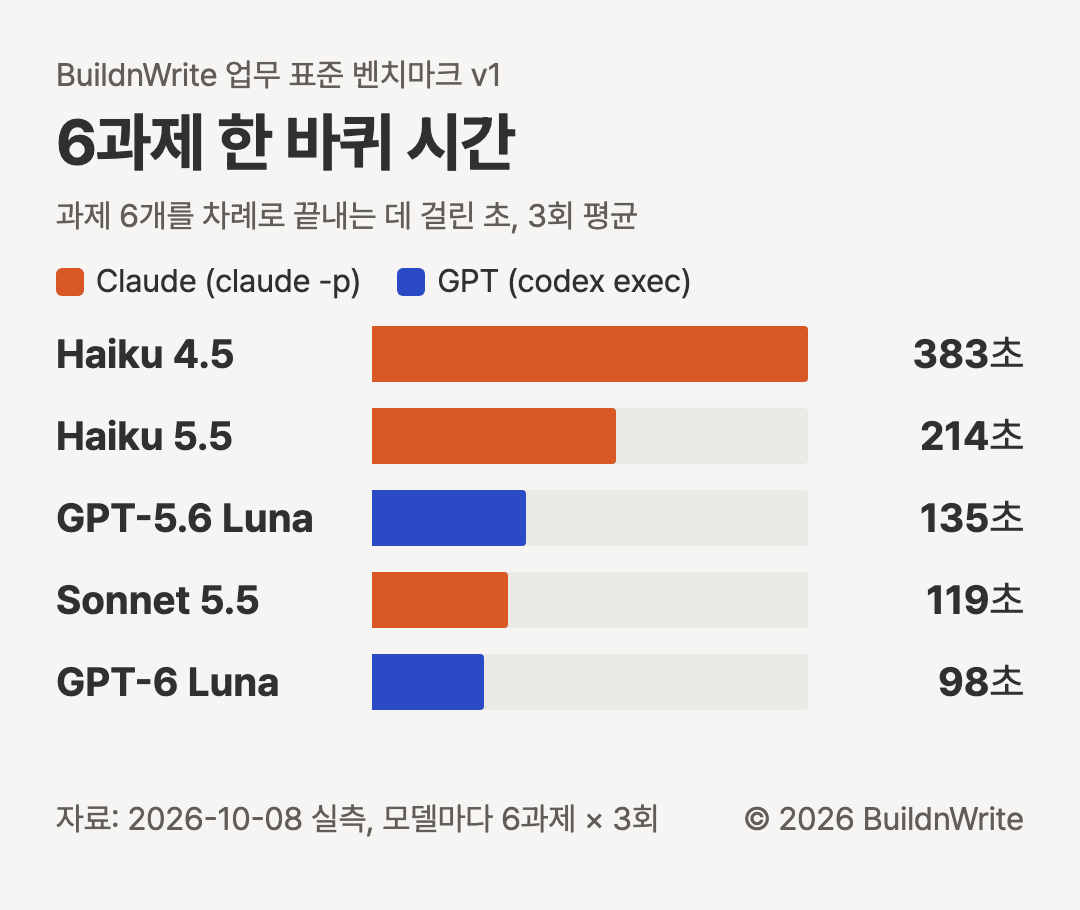
하이쿠 5.5의 시간은 대부분 채점 과제에서 나왔고, 그 과제에서 생각 토큰이 다른 모델보다 많았습니다.
| 모델 | 채점 과제 생각 토큰 (1, 2, 3회차) | 채점 과제 평균 시간 |
|---|---|---|
| Haiku 5.5 | 20,160 / 27,199 / 36,609 | 133초 |
| Haiku 4.5 | 6,581 / 14,965 / 21,317 | 149초 |
| Sonnet 5.5 | 1,494 / 1,825 / 1,258 | 33초 |
| GPT-6 Luna | 1,254 / 0 / 562 | 29초 |
- 하이쿠 5.5는 medium에서도 소넷 5.5보다 13배에서 29배 많이 생각했습니다. 그래도 단가가 낮아 비용은 소넷의 4분의 1 아래였습니다.
- 나머지 과제에서는 하이쿠 5.5도 과제당 11초에서 26초였습니다. 이번에 느렸던 것은 채점 과제 하나에서였습니다.
- 생각 토큰만으로 시간이 다 설명되지는 않습니다. 하이쿠 4.5는 생각 토큰이 더 적은데도 채점 과제가 더 오래 걸렸습니다.
- 속도가 중요하면 effort를 low로 내려 다시 재 볼 만합니다. 이번 회차에서는 재지 않았습니다.
8. 이 실험의 한계
- 과제마다 3회씩이라 표본이 작습니다. 회차별 범위가 겹치는 모델끼리는 순위를 정할 수 없습니다.
- 6과제 중 4과제가 모든 모델에서 만점이라 변별력이 낮았습니다. 다음 판에서는 판단이 드는 과제를 늘립니다.
- 모델과 도구를 묶어 쟀습니다. 같은 모델을 API로 직접 부르면 두 도구의 기본 지시문이 모두 빠지므로 비용 비교가 달라질 수 있습니다. 이번에는 재지 않았습니다.
- 채점표는 이전 실험에서 하이쿠 4.5의 오답을 보고 고친 것이라 하이쿠 4.5에 유리할 수 있습니다.
- 채점 과제를 뺀 다섯 과제의 문구와 자료는 클로드(Opus 5.5)가 만들었습니다. 이것이 어느 쪽에 유리한지는 확인하지 않았습니다.
- 추론 강도는 medium 하나로만 쟀고, 같은 medium이라도 회사마다 생각하는 양이 다릅니다.
9. 정리
- 하이쿠 5.5와 GPT-6 Luna는 이 과제들에서 점수가 비슷했고, 비용과 시간은 GPT-6 Luna가 앞섰습니다.
- 이 실험 조건(클로드 코드, 6과제)에서 하이쿠 5.5의 비용은 하이쿠 4.5의 약 10분의 1이었습니다. 공식 발표의 평균 인하 폭은 약 75%입니다.
- 이 벤치마크는 새 모델이 나올 때마다 같은 과제로 다시 재서 이 글 아래 결과를 이어 붙일 예정입니다.
자주 묻는 질문
- GPT 루나와 클로드 하이쿠 5.5 중 무엇이 업무에 더 낫나요?
- 업무 과제 6개를 3번씩 돌린 이 실험에서 평균 점수는 하이쿠 5.5 94.8점, GPT-6 Luna 93.3점으로 차이가 작았고 회차별 범위도 겹쳤습니다. 추출, 분류, 표 분석, 코드 수정은 두 모델 모두 만점이었습니다. 비용은 GPT-6 Luna가 6과제 한 바퀴 0.013달러로 하이쿠 5.5(0.050달러)보다 쌌고, 시간도 98초로 하이쿠 5.5(214초)보다 짧았습니다(2026년 10월 8일 실측).
- 하이쿠 4.5에서 하이쿠 5.5로 바꾸면 비용이 얼마나 줄어드나요?
- 같은 6과제를 클로드 코드로 돌린 이 실험에서 한 바퀴 비용(API 단가 환산)은 하이쿠 4.5 0.479달러, 하이쿠 5.5 0.050달러로 약 90% 줄었습니다. 평균 점수는 95.4점과 94.8점으로 비슷했습니다.
댓글