클로드 코드, 코덱스 대 Jev: 판단 전용 AI 모델의 속도와 비용 비교
이 글의 독자AI 코딩 도구를 하나쯤 써 봤고 Jev가 뭐길래 다들 얘기하는지 궁금하지만, 모델 구조 설명은 읽고 싶지 않은 실무자
한줄 요약: 지난주 X를 뒤덮은 Jev는 클로드 코드나 코덱스처럼 글과 코드를 쓰는 AI가 아니라, 정해진 선택지 중 답만 고르는 판단 전용 모델입니다. 공식 벤치마크에서 정확도는 Opus 5보다 5점 낮았지만 비용은 440분의 1, 응답은 0.4초였습니다. 무엇이 다르고 어디에 끼워 쓰는지 초보자 눈높이로 정리했습니다.
목차
- Jev가 뭔가요: 글을 안 쓰는 AI
- 세 가지 한눈에: 클로드 코드, 코덱스, Jev
- 성능은 얼마나 다른가: 공식 벤치마크
- 어디에 끼워 쓰나: 코딩 에이전트 안의 문지기
- 써 본 사람들의 말
- 직접 만져 보기: 대기열과 플레이그라운드
- 고르는 기준
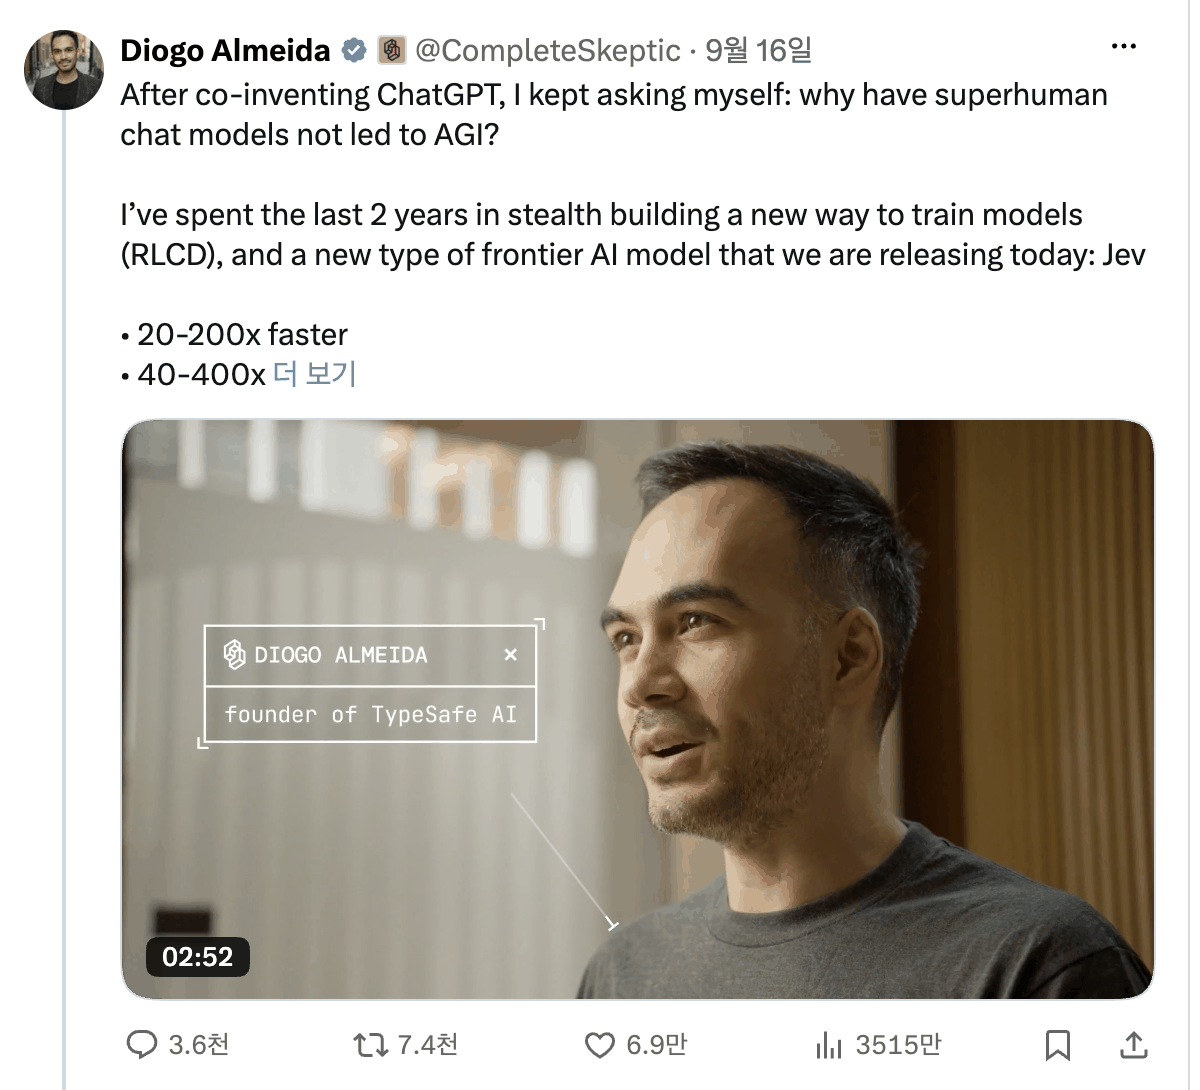
2026년 9월 15일, ChatGPT를 함께 만들었던 Diogo Almeida가 회사 TypeSafe AI와 첫 모델 Jev를 공개했습니다. 발표 글 하나가 Hacker News에서 1,890점을 받았고, X에서는 발표 글이 3,500만 회 넘게 조회됐습니다. 그런데 화제에 비해 “그래서 이게 뭔데”라는 질문에 답하는 글은 드뭅니다. 이 글은 클로드 코드와 코덱스를 써 본 사람이 Jev를 어디에 두고 봐야 하는지에 답합니다.
1. Jev가 뭔가요: 글을 안 쓰는 AI
Jev는 TypeSafe AI가 만든 모델입니다. 회사는 이 모델을 “System One 모델”이라는 새 부류로 부릅니다. 빠르고 직관적인 판단을 뜻하는 심리학 용어에서 가져온 이름입니다.
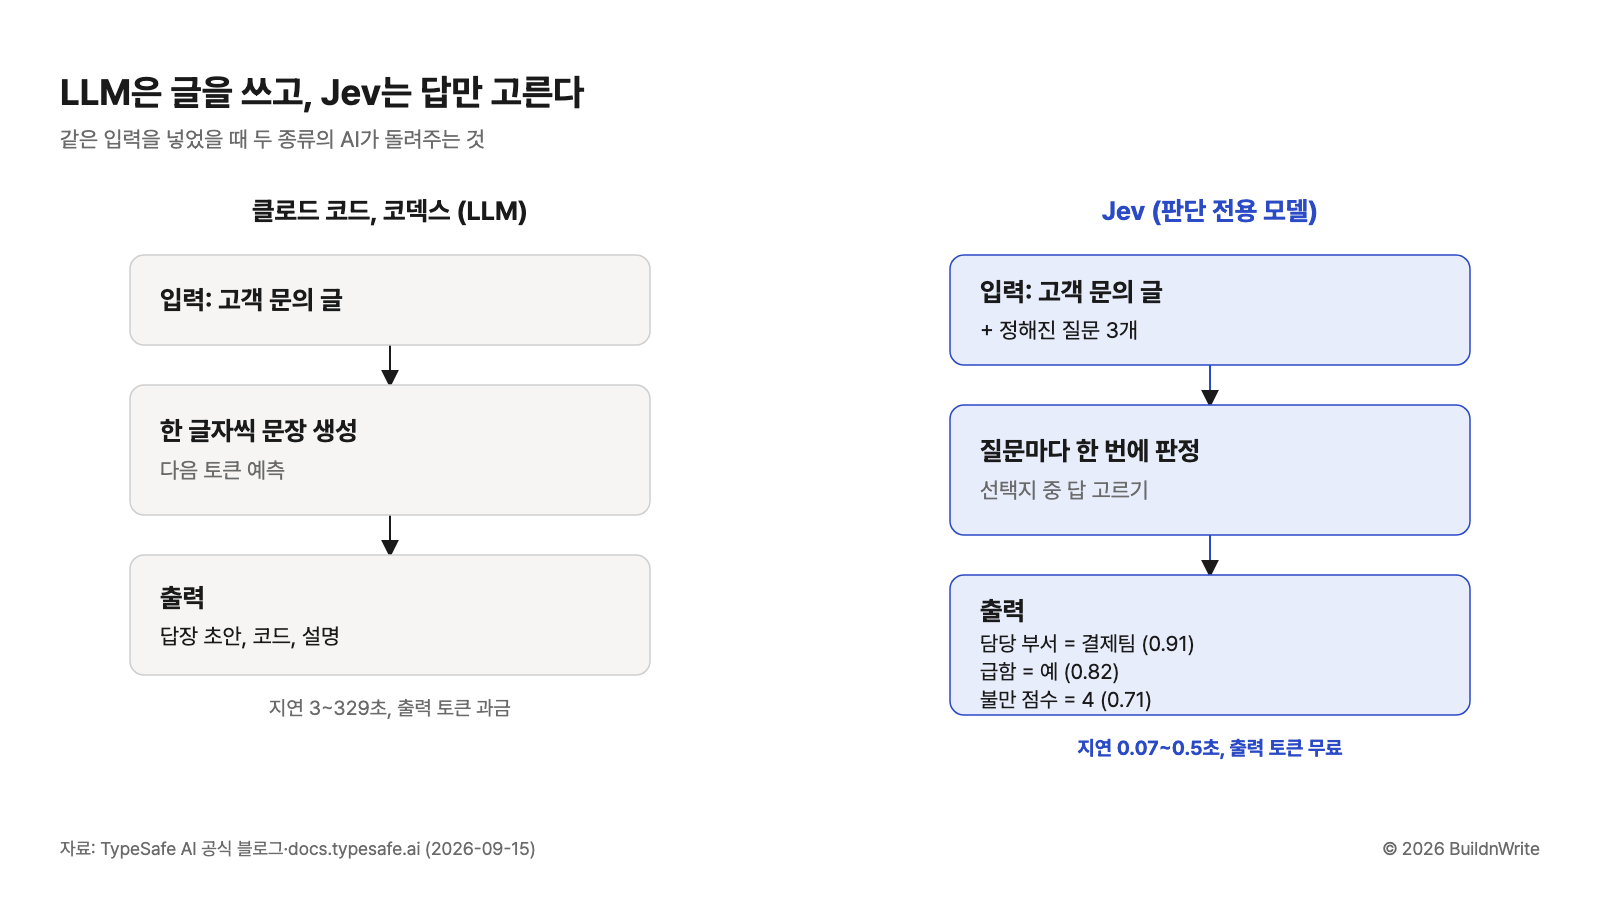
가장 큰 특징은 글을 한 글자도 쓰지 않는다는 점입니다. 클로드 코드와 코덱스는 질문을 받으면 답장, 코드, 설명을 문장으로 써 내려갑니다. Jev는 대신 아래 세 가지 형태의 답만 돌려줍니다.
| 질문 형태 | 무엇을 묻나 | 돌아오는 답 |
|---|---|---|
| Choice | 여러 선택지 중 하나 | 고른 항목 + 확신도 |
| Score | 정해진 척도 위의 점수 | 점수 + 확신도 |
| Noul | 예 아니오 | 예일 확률 |
확신도는 모델이 자기 답을 얼마나 믿는지 0과 1 사이 숫자로 낸 값입니다. 후기에서는 신뢰도라고도 부릅니다.
창업자는 X에서 이 절충을 직접 밝혔습니다. “이득은 공짜가 아니다. Jev는 텍스트를 생성하지 못한다”(번역, @CompleteSkeptic)는 문장이 발표 스레드 두 번째 글입니다.
2. 세 가지 한눈에: 클로드 코드, 코덱스, Jev
이름을 나란히 두면 경쟁 제품처럼 보이지만 하는 일이 다릅니다. 같은 표에 놓고 차이부터 봅니다.
| 항목 | 클로드 코드 | 코덱스 | Jev |
|---|---|---|---|
| 만든 곳 | Anthropic | OpenAI | TypeSafe AI |
| 하는 일 | 코드 읽기, 수정, 명령 실행 | 코드 읽기, 수정, 명령 실행 | 정해진 질문에 답 고르기 |
| 돌려주는 것 | 문장, 코드, 파일 변경 | 문장, 코드, 파일 변경 | 선택지, 점수, 확률 |
| 뒤에서 도는 모델 | Sonnet 5 (Pro), Opus 5 (Max) | GPT-5.6 계열 (Sol, Terra, Luna) | Jev 1.13 |
| 개인 요금 | Pro 월 $20부터 | Plus 월 $20부터, 무료 플랜 일부 | 입력 100만 토큰당 $0.042, 출력 무료 |
| 쓰는 자리 | 터미널, IDE, 데스크톱 앱, 웹 | 터미널, IDE, 앱, 웹, 클라우드 | 내 코드에서 API 호출 |
| 공개 상태 | 정식 | 정식 | 얼리 액세스 (대기열) |
요금과 기본 모델은 2026년 9월 각 회사 공식 문서 기준입니다. 출처는 Claude 요금과 클로드 코드 모델 설정, 코덱스 요금, TypeSafe 모델 문서입니다.
3. 성능은 얼마나 다른가: 공식 벤치마크
TypeSafe는 평가 페이지를 따로 열어 두었습니다. 보안 경보 처리, 상담 기록 점검, 송장 처리, 고객 응대 네 가지 업무를 판단 문제로 쪼개고, 모델마다 정확도와 케이스당 비용, 걸린 시간을 쟀습니다.
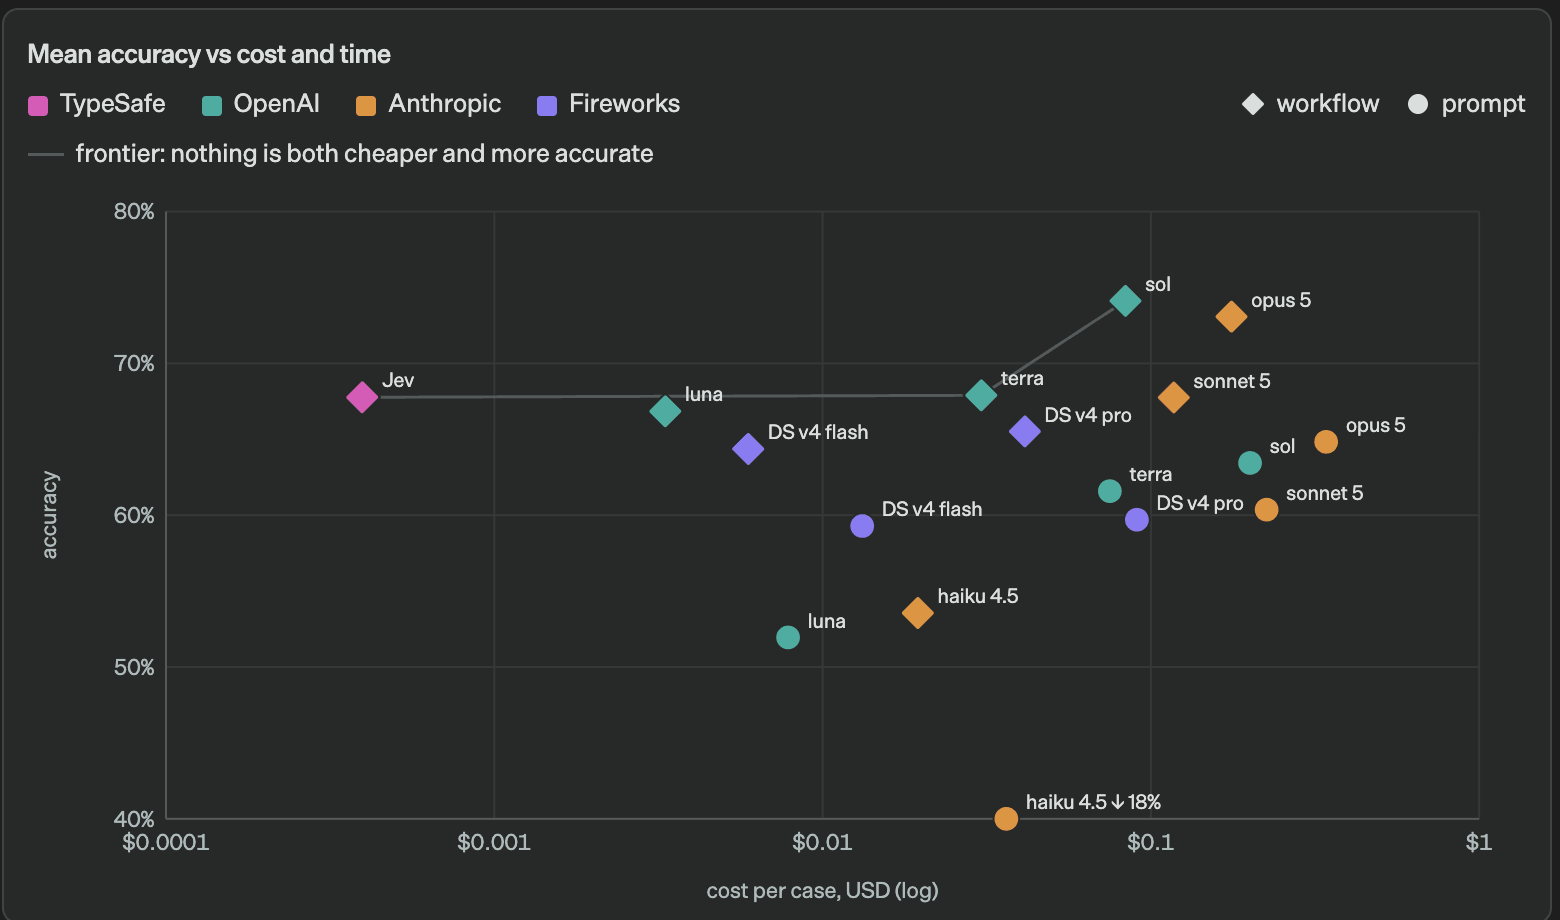
네 업무의 평균을 표로 옮기면 아래와 같습니다. 모든 모델을 Jev와 같은 워크플로 방식, 곧 업무를 작은 판단 질문으로 쪼개서 푸는 방식으로 돌린 값입니다. 정확도는 사람이 매긴 정답이 아니라 GPT-6 Astra와 Claude Fable 5.1이 만든 참조 답과의 일치율입니다.
| 모델 | 정확도 | 케이스당 비용 | 걸린 시간 |
|---|---|---|---|
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3초 |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8초 |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1초 |
| Jev | 67.8% | $0.0004 | 0.4초 |
| Claude Sonnet 5 | 67.8% | $0.1174 | 78.1초 |
| GPT-5.6 Luna | 66.8% | $0.0033 | 12.9초 |
| Claude Haiku 4.5 | 53.6% | $0.0195 | 12.5초 |
자료: evals.typesafe.ai 개요 표의 워크플로 값, 2026년 9월 19일 열람. 각 모델은 제공사 기본 설정으로 돌렸고, 같은 페이지는 한 번에 통째로 묻는 프롬프트 방식보다 워크플로 방식이 모든 모델에서 더 정확하고 싸고 빨랐다고 적었습니다.
발표 글이 강조한 “환각 0%“도 그대로 받지 않는 편이 좋습니다. 발표 글 자체가 이 수치는 실험값이 아니라 정해진 형식 밖의 답을 낼 수 없다는 구조적 보장이라고 적어 두었습니다. 형식 안에서 틀린 답을 고를 수는 있습니다.
4. 어디에 끼워 쓰나: 코딩 에이전트 안의 문지기
Jev가 코드를 못 쓰는데 왜 클로드 코드와 코덱스 사용자들이 반응했을까요. 코딩 에이전트가 일하는 동안 수없이 내리는 작은 판단 자리에 들어갈 수 있기 때문입니다.
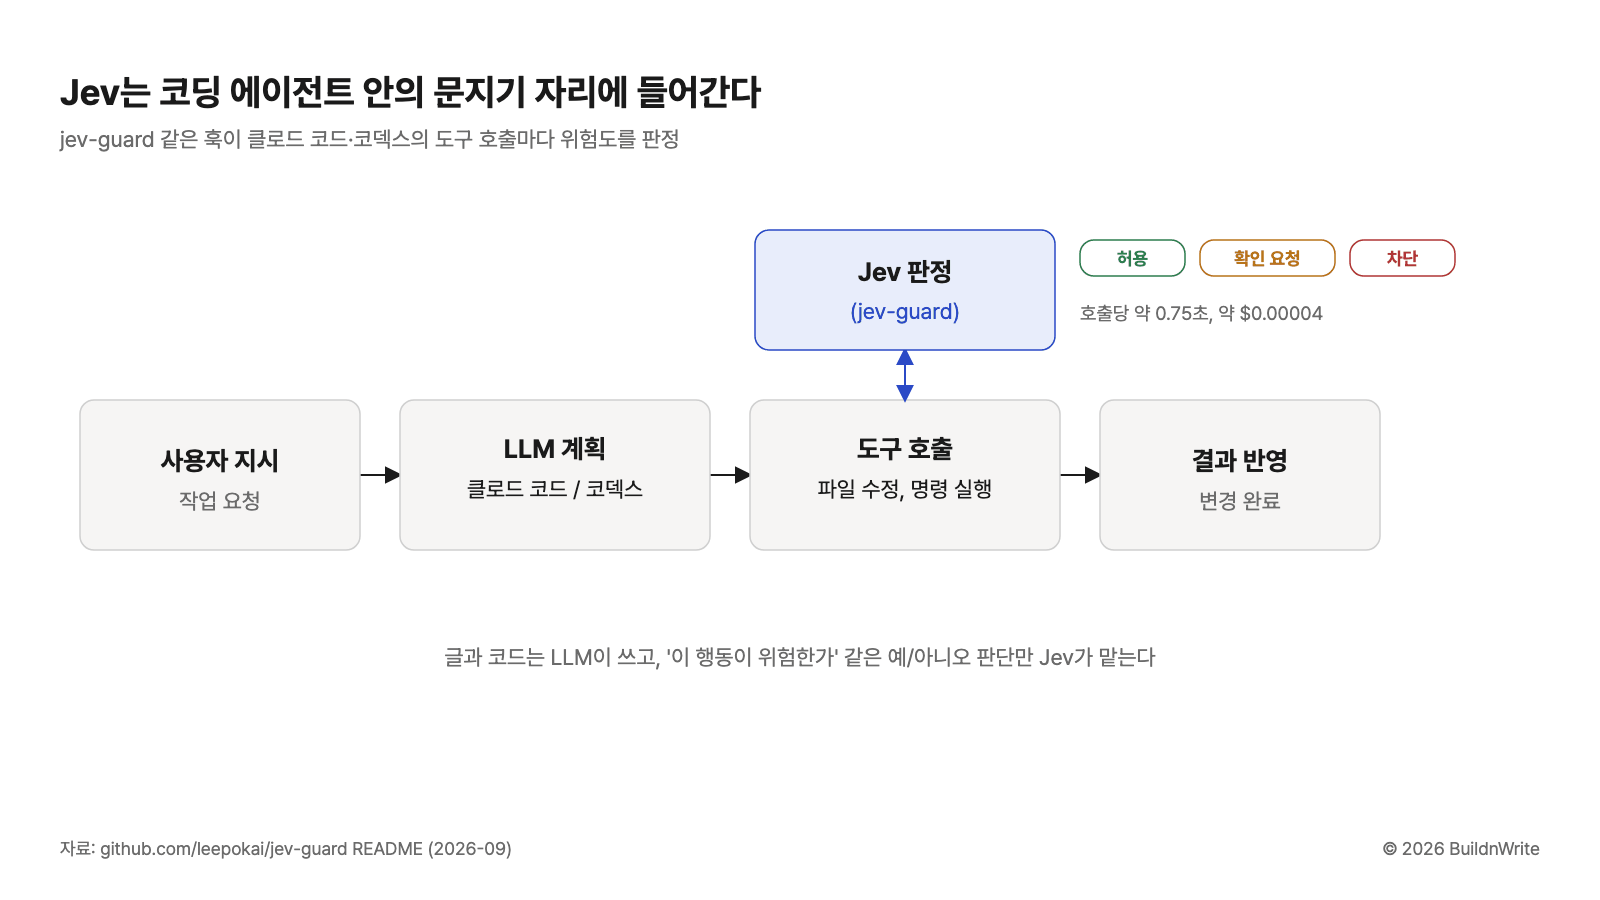
발표 나흘 만에 이런 훅을 만든 공개 프로젝트가 여럿 나왔습니다. 모음집 awesome-jev에서 클로드 코드와 코덱스에 바로 붙는 것만 추렸습니다.
| 프로젝트 | 하는 일 | 붙는 도구 | README의 실측 |
|---|---|---|---|
| jev-guard | 도구 호출마다 위험도 판정, 프롬프트 주입 검사 | 클로드 코드, 코덱스, Copilot과 Gemini의 터미널 도구, Cursor 등 | 호출당 약 0.75초, 약 $0.00004 |
| jev-judgment | 예 아니오형 판단만 Jev에 넘기고 주 모델은 코드에 집중 | 코딩 에이전트 스킬 | 약 250ms |
| limpet | 에이전트가 일을 덜 끝내고 멈추려 할 때 규칙과 대조해 계속시킴 | 클로드 코드류 종료 훅 | 약 0.7초, 하루 수 센트 |
5. 써 본 사람들의 말
발표 글의 Hacker News 스레드는 댓글이 495개입니다. 직접 써 본 사람과 아직 대기열에 있는 사람이 섞여 있어서, 어느 쪽인지 표시하고 옮깁니다.

대기열에서 승인을 받았는데 정말 괜찮다. 참고로 지금은 Vercel 게이트웨이에도 올라와 있다. (번역)
(Hacker News, porr**** 님, 직접 사용)
얼리 액세스로 써 봤는데 꽤 유용했다. 여러 질문을 예 아니오 형태로 던져 두 번째 검증 수단으로 삼으니 다른 모델 출력에 대한 확신이 올라갔다. 이런 모델은 LLM을 대체하는 게 아니라 같이 쓸 때 아주 잘 돌아간다. (번역)
(Hacker News, tyle**** 님, 직접 사용)
속도 비교가 오해를 부르는 것 같다. Jev는 구조화된 출력만 낼 수 있지 않나. 분류, 라우팅, 점수 매기기에는 아주 유용하겠지만 우리가 지금 코드와 자동화에 쓰는 코드 생성 모델과는 전혀 다른 것이다. (번역)
(Hacker News, jaco**** 님, 발표 글 검토)
OpenRouter에 올라와서 오늘 하루 종일 가드를 만들고 있다. 다른 아이디어도 꽤 있다. 엄청나게 편하다. (번역)
(Reddit r/PiCodingAgent, fing**** 님, 직접 사용)
이 모델의 과장이 이해가 안 된다. 어떤 LLM이든 출력 제약을 걸어 병렬로 답하게 만들 수 있다. 나도 비슷한 걸 만들어 노트북에서 돌리고 있다. (번역)
(Reddit r/PiCodingAgent, No_I**** 님, 유사 구현)
국내에서는 GeekNews에 소개 글과 댓글이 올라왔습니다.
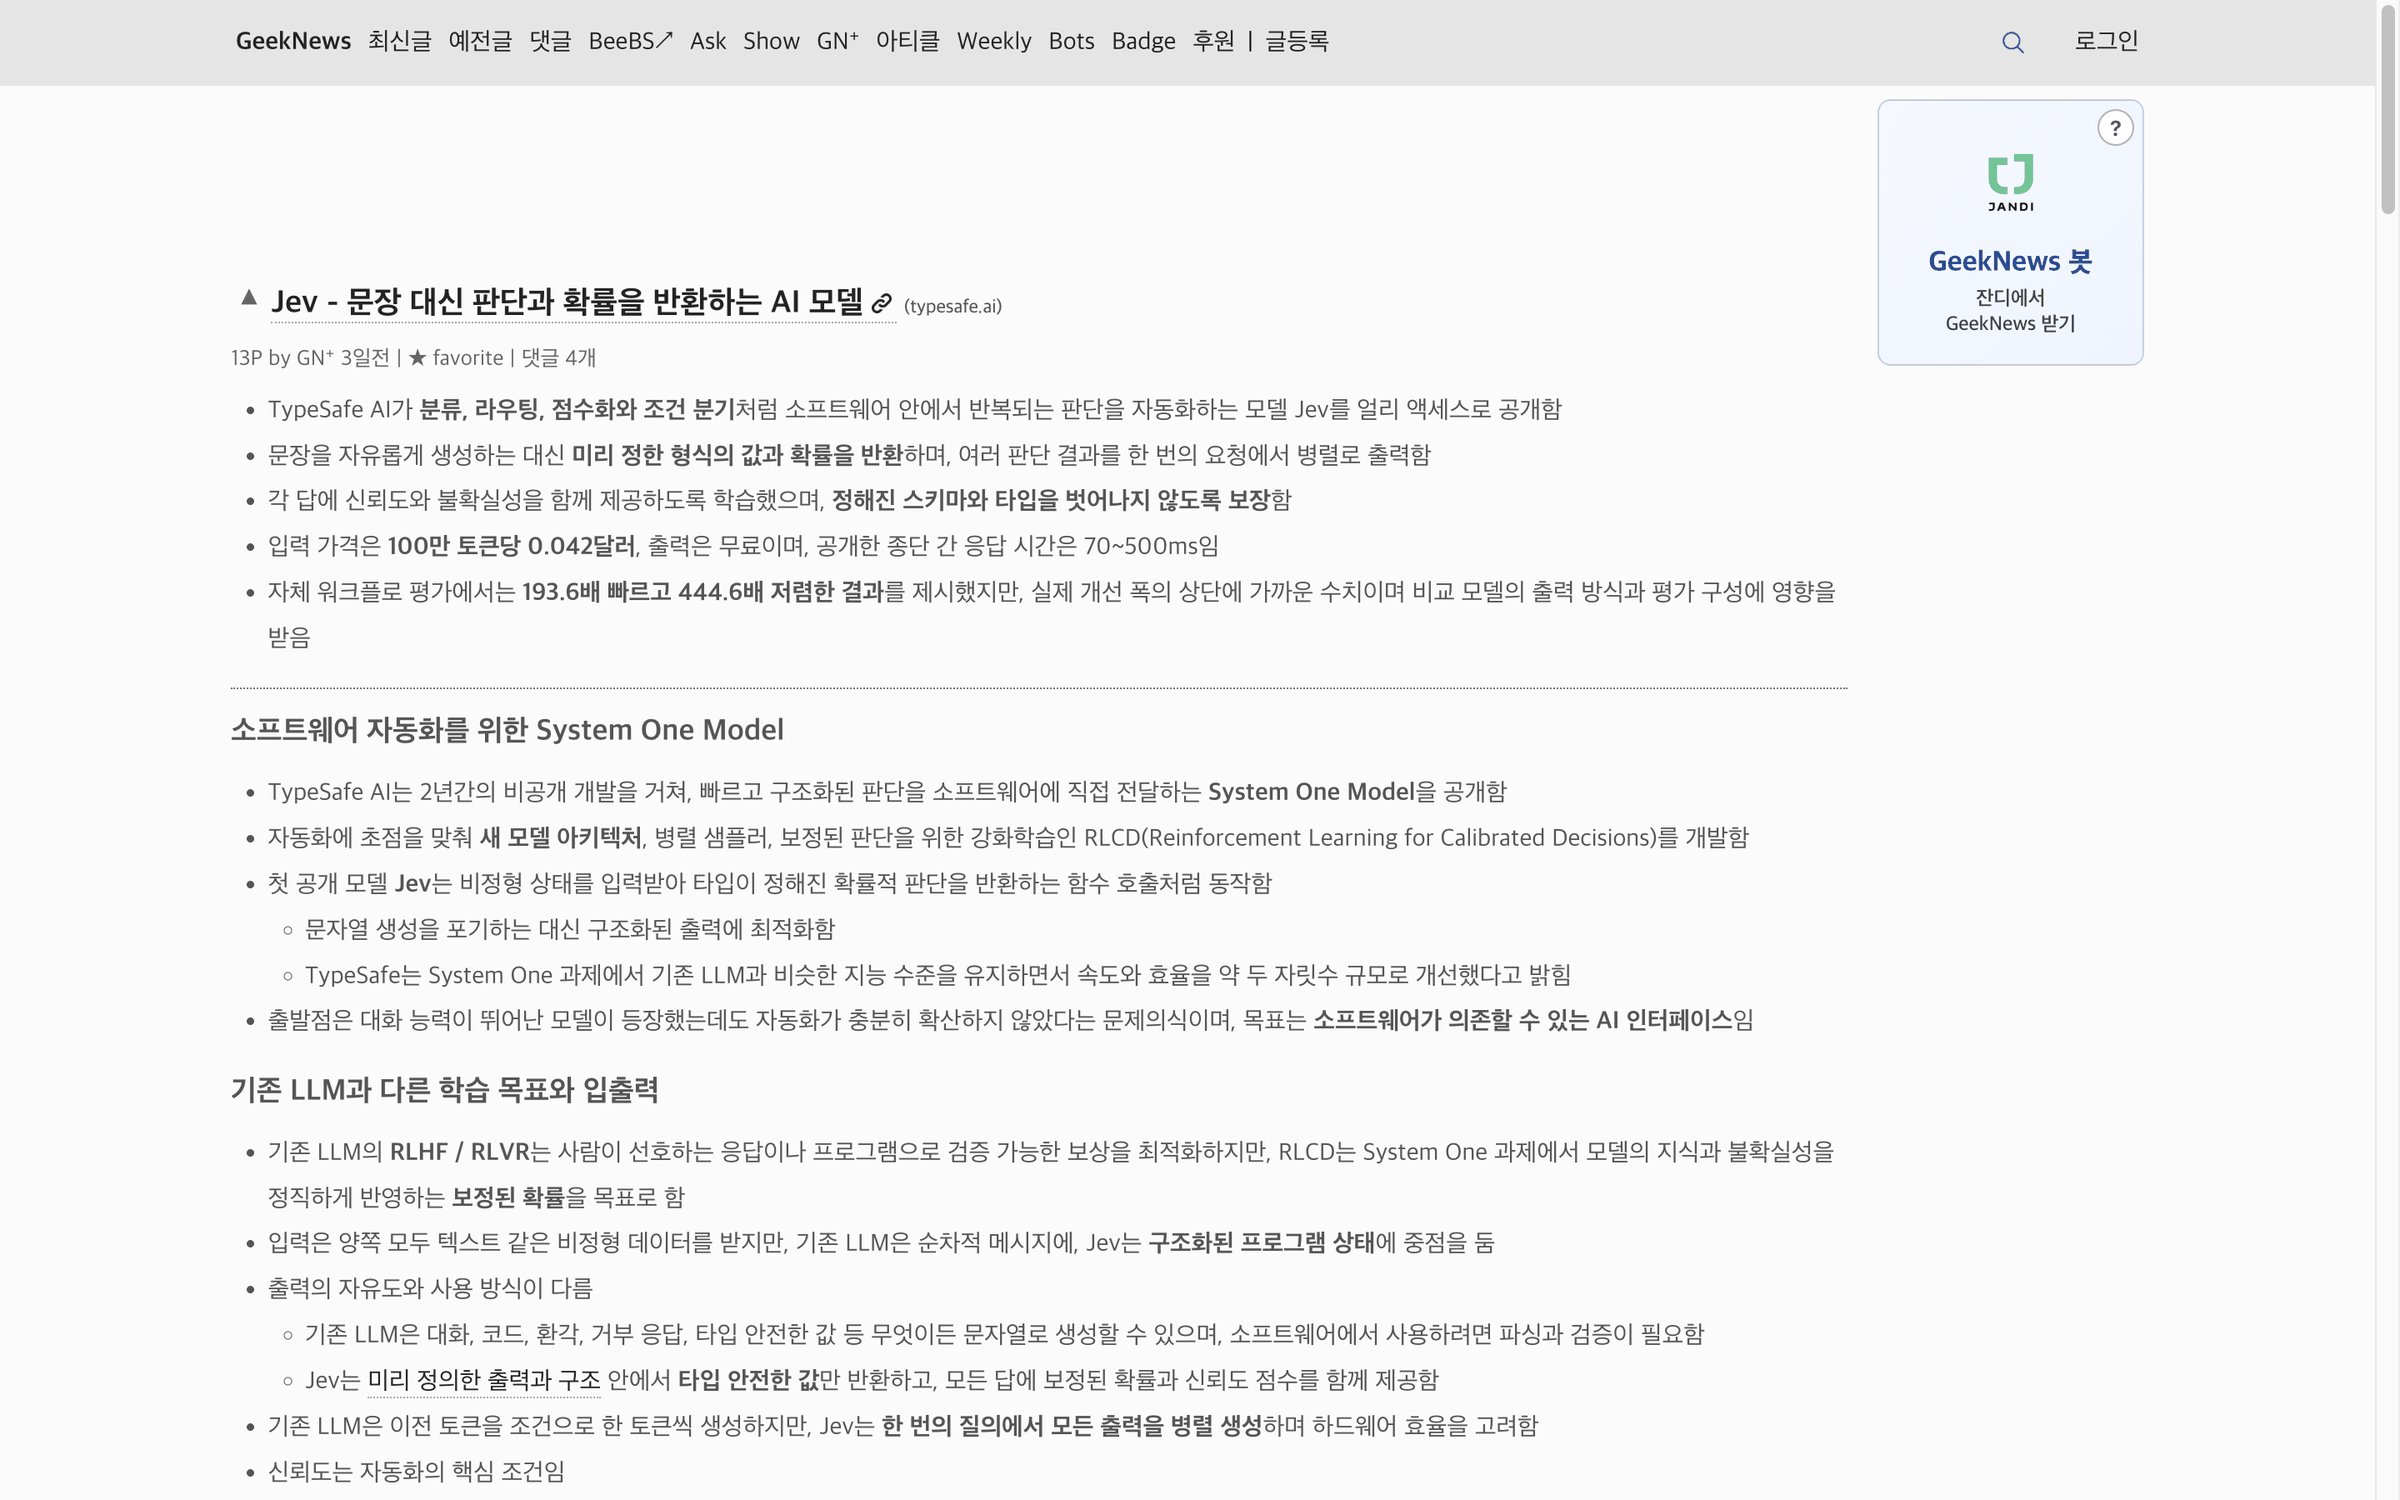
방금 실제 Jev로 확인했는데, 62ms 만에 1이 나올 확률 84%, 신뢰도 83%를 반환함.
(GeekNews 댓글, 주사위 질문 실험, 직접 사용)
Jev는 그보다 일관된 성능을 내며, 낮은 비용과 지연 시간으로 대략 GPT-5.6 Terra 수준에 도달한다고 함. 현재 시험 중인데 유망해 보임.
(GeekNews 댓글, BART 분류기와 비교, 시험 중)
반대편 실험도 있습니다. X의 한 개발자는 작은 공개 모델 Gemma 3 270M으로 질문을 한꺼번에 묶어 첫 토큰의 확률만 읽는 방식을 시험했고, 같은 모델이 JSON 전체를 쓰게 할 때보다 약 77배 빨랐다고 적었습니다(번역, @nwnwnyo). Jev가 특별한 게 아니라 “글을 안 쓰면 원래 빠르다”는 반론입니다.
6. 직접 만져 보기: 대기열과 플레이그라운드
지금은 대기열을 거쳐야 합니다. 신청부터 첫 질문까지의 순서입니다.
- typesafe.ai에서 Join Waitlist를 누르고 이메일을 넣습니다.
- 승인 메일이 오면 console.typesafe.ai에 그 이메일이나 구글 계정으로 들어갑니다.
- 콘솔의 Playground를 열고 아무 글이나 붙여 넣습니다. 공식 예시는 “Stripe 연결이 3일째 안 된다”는 고객 문의입니다.
- 질문 하나를 더합니다. 예시는 Noul 형태의 “이 메시지가 급함을 드러내는가”입니다.
- 결과에 예일 확률과 확신도가 찍히면 끝입니다. Choice와 Score를 섞어 한 번에 여러 질문을 던져 봅니다.
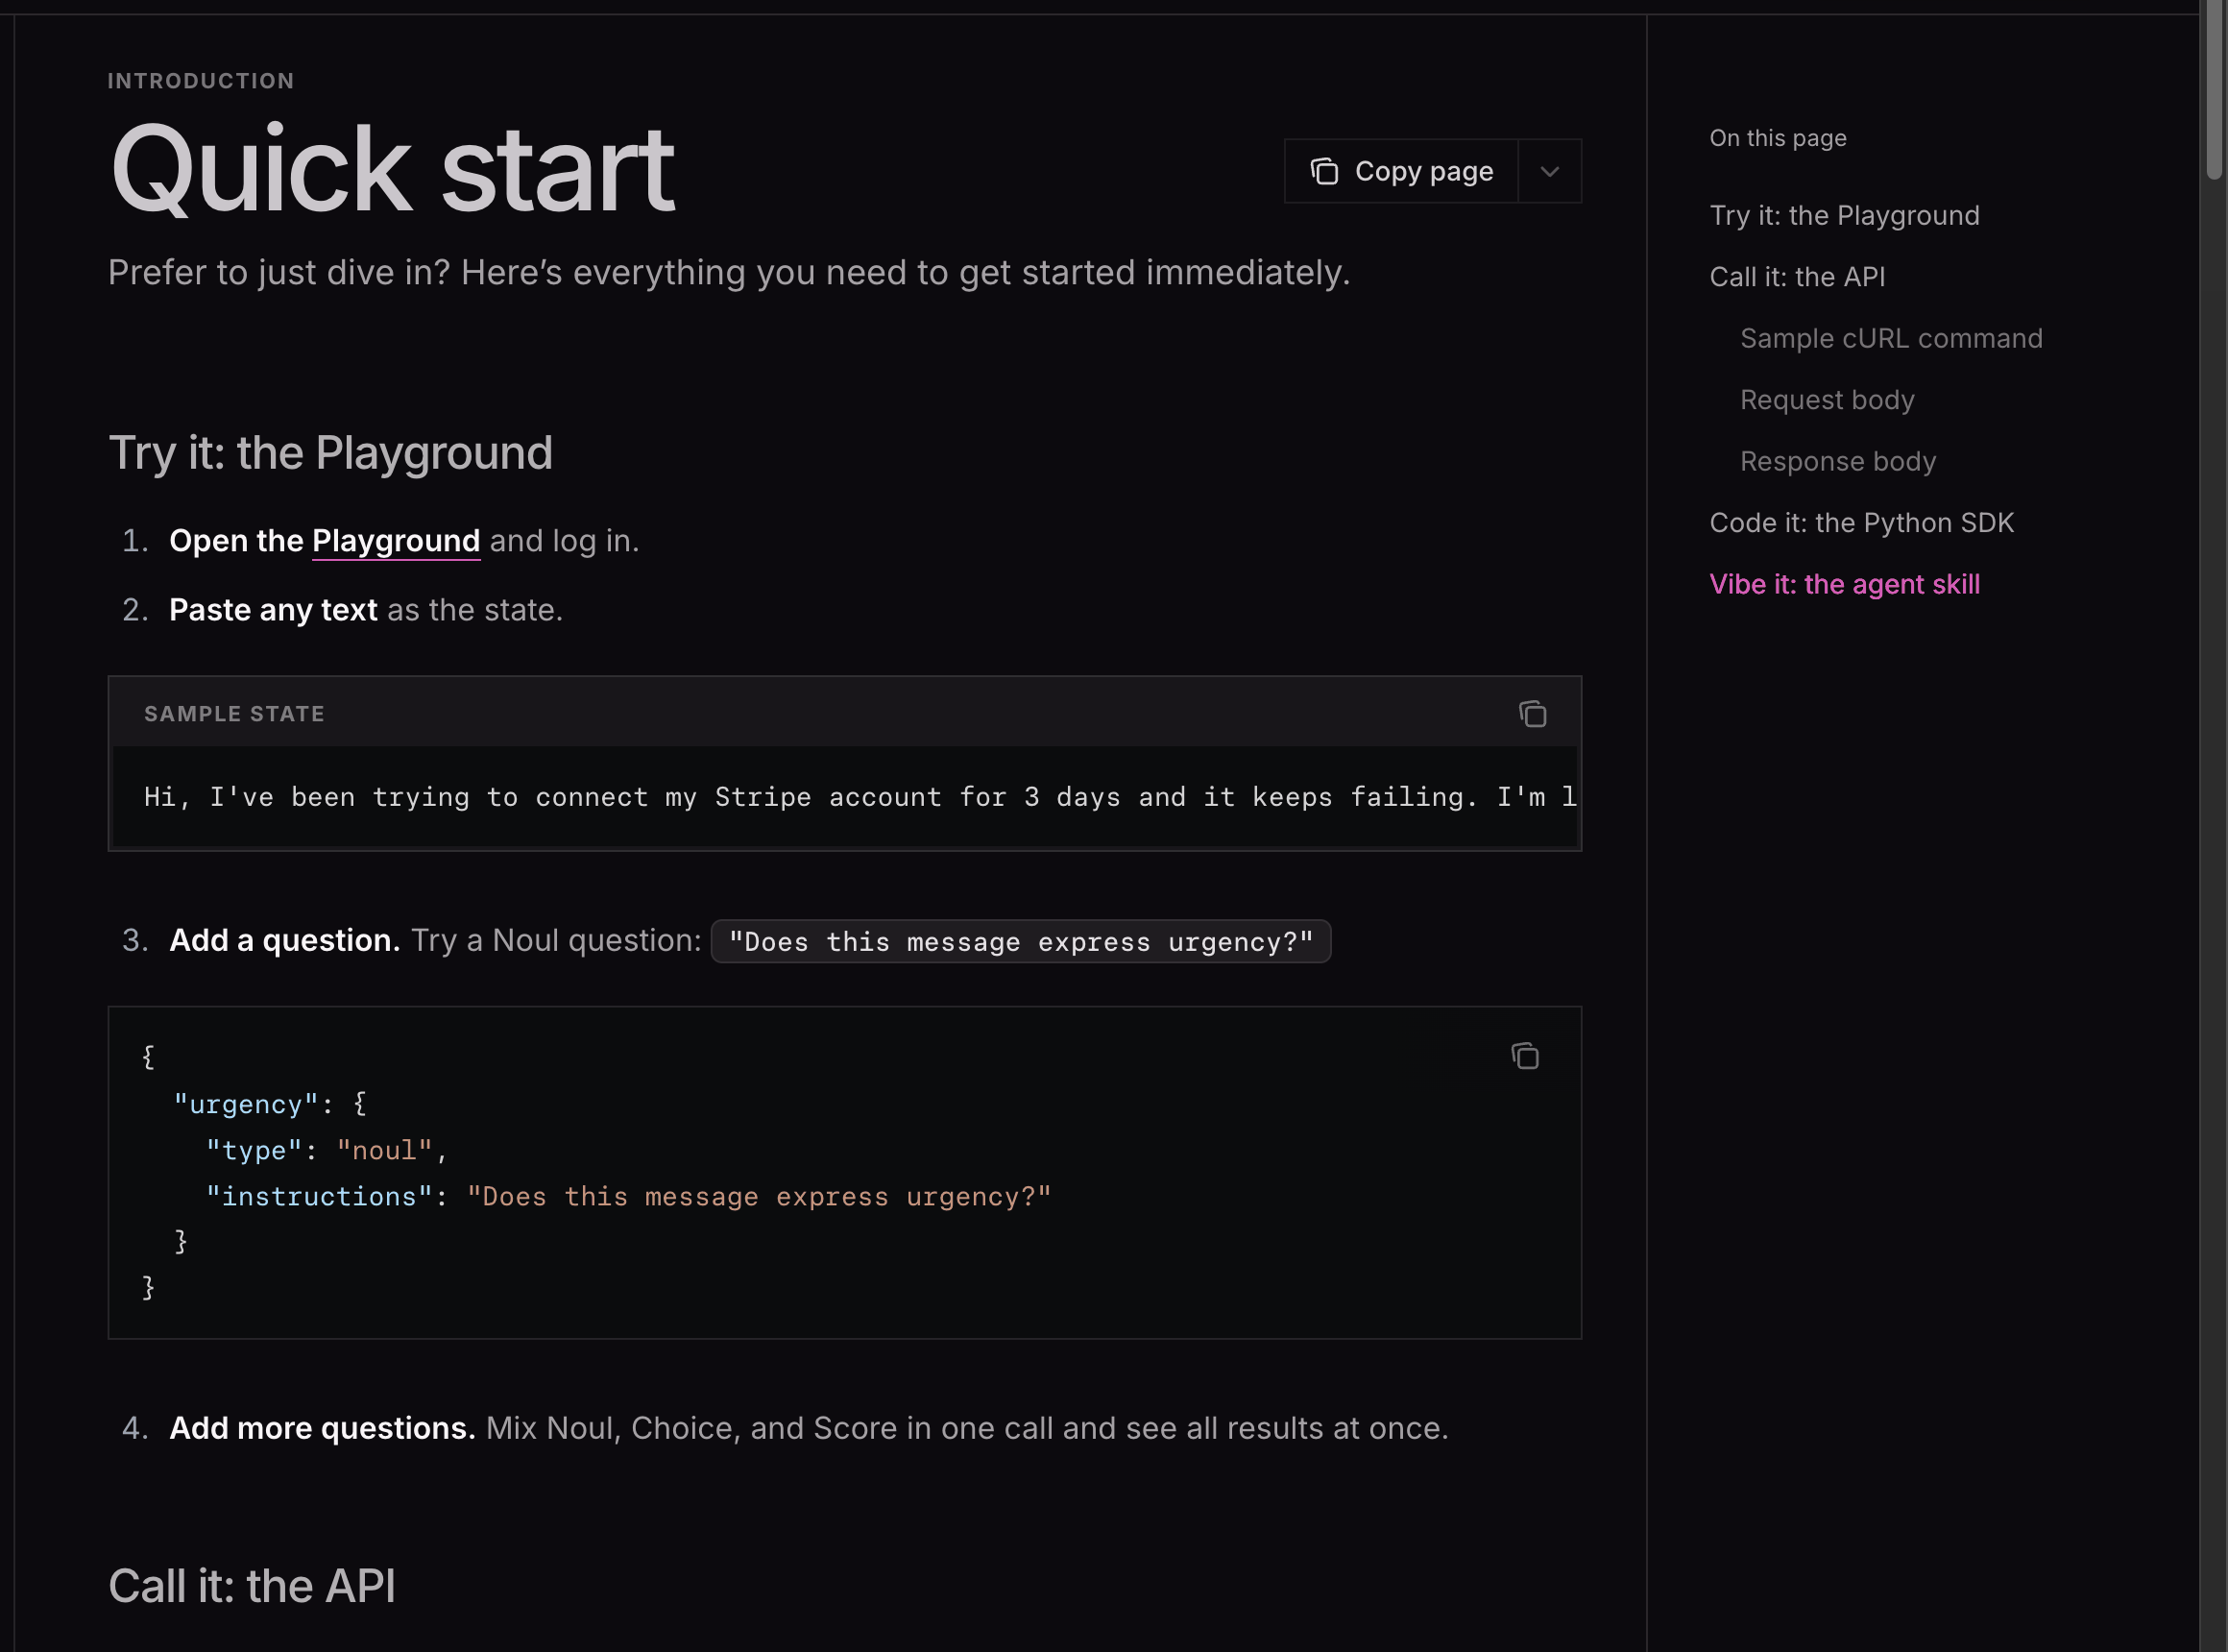
코드로 부르려면 파이썬 패키지를 하나 깔면 됩니다. 아래는 공식 퀵스타트의 예시를 줄인 것입니다.
from typesafe_sdk import Choice, Noul, TypeSafeClient

client = TypeSafeClient()  # 환경변수 TYPESAFE_API_KEY를 읽습니다
response = client.system_one(
    state="Stripe 연결이 3일째 안 됩니다. 결제가 계속 실패해요.",
    questions={
        "department": Choice(
            instructions="어느 팀이 맡아야 하나",
            criteria={"billing": "결제 문제", "tech": "기술 문제"},
        ),
        "is_urgent": Noul(instructions="급함을 드러내는 메시지인가"),
    },
)7. 고르는 기준
| 하려는 일 | 먼저 볼 것 | 이유 |
|---|---|---|
| 기능 만들기, 버그 고치기, 문서 쓰기 | 클로드 코드, 코덱스 | 문장과 코드를 써야 하는 일 |
| 문의 분류, 위험 여부 판정, 점수 매기기 | Jev | 답이 선택지 안에 있고 초당 여러 번 부르는 일 |
| 코딩 에이전트의 위험 행동 차단 | 클로드 코드 또는 코덱스 + jev-guard | 쓰는 쪽과 판정하는 쪽을 나누는 구성 |
| 이유를 설명해야 하는 판단 | 클로드 코드, 코덱스 | Jev는 왜 그렇게 골랐는지 말하지 않음 |
댓글