챗GPT GPT-6 업데이트: 인텔리전트 UI와 무료 요금제 적용 범위
이 글의 독자챗GPT를 무료나 Plus 요금제로 쓰면서, 이번 GPT-6 업데이트로 답변이 어떻게 달라지고 내 요금제에는 언제 적용되는지 알고 싶은 사람
한줄 요약: 2026년 10월 7일부터 챗GPT 채팅 탭의 GPT-6가 질문에 맞춰 그림, 차트, 버튼, 입력 칸, 계산기 같은 화면 요소를 섞어 답하고, 생각하는 중에도 먼저 답을 시작합니다. Plus, Pro, Business, Enterprise는 10월 7일, Free와 Go는 10월 8일부터 순차 적용입니다. 무료나 Plus로 챗GPT를 쓰는 사람도 순서대로 받게 되는 변화입니다.
목차
2026년 10월 7일, OpenAI가 GPT-6 and Intelligent UI for everyone를 발표했습니다. 아래 내용은 이 발표와 같은 날 갱신된 ChatGPT 릴리스 노트, 시스템 카드를 기준으로 정리했습니다.
1. 무엇이 바뀌었나
OpenAI는 지난달 유료 고객에게 첫 GPT-6 모델을 냈고, 이번에는 매주 챗GPT를 쓰는 12억 명 이상을 위한 새 GPT-6 모델을 내놓는다고 밝혔습니다. 릴리스 노트에는 9월 3일 GPT-6 Astra, 9월 22일 Work와 Codex(채팅 탭 밖의 업무, 코딩 도구)용 GPT-6 Sol과 Luna가 올라와 있습니다. Work와 Codex에는 9월 29일 GPT-6.1 Sol 배포도 Pro부터 시작됐습니다.
이번 발표의 변화는 두 가지입니다.
- 인텔리전트 UI: 질문에 따라 텍스트, 그림, 누르는 버튼, 입력 폼, 차트, 대화 안에서 바로 쓰는 도구를 섞어 답한다.
- 생각하면서 답하기: 다 생각한 뒤가 아니라 생각하거나 도구를 쓰는 중에도 답을 시작하고, 사용자가 다시 묻지 않아도 찾은 내용을 덧붙인다.
시스템 카드는 이번 모델이 챗GPT 안의 GPT-5.6 Sol과 GPT-5.6 Luna를 대체한다고 적었습니다.
2. 요금제별 모델과 적용 시점
모든 요금제에서 대상은 챗GPT의 채팅 탭입니다.
| 요금제 | 모델 | 적용 시작 | 조건 |
|---|---|---|---|
| Plus, Pro, Business, Enterprise | GPT-6 Sol | 10월 7일 | Enterprise는 워크스페이스 관리자 설정에 따라 다름 |
| Free, Go | GPT-6 Luna | 10월 8일 | 발표에 별도 언급 없음 |
- 발표는 Sol과 Luna 모두 일상 대화에 맞춰 조정했다고 설명합니다.
- 날짜는 발표 게시일(10월 7일)을 기준으로 “오늘”과 “다음 날”을 옮긴 것이고, 시간대는 적혀 있지 않습니다. 적용은 전 세계 순차 배포라 적용일이 지나도 아직 안 보이는 계정이 있을 수 있습니다. 국가별 일정은 따로 적혀 있지 않습니다.
- 릴리스 노트는 인텔리전트 UI를 Instant부터 Extra High 단계까지 쓸 수 있다고 적었습니다. 지금 요금제별로 고를 수 있는 단계는 이번 발표에 없습니다.
- 이전 릴리스 노트에는 6월 10일 Extra High가 Pro 전용으로, 8월 6일 Plus와 Pro에 생각하는 정도를 고르는 슬라이더가 들어오고 그다음 주부터 Free와 Go에 Think 버튼이 생긴다고 적혀 있습니다. 이번 발표가 이 구성을 바꿨는지는 적혀 있지 않습니다.
3. 인텔리전트 UI가 만드는 답변
발표는 GPT-6가 질문을 보고 형식을 고른다고 설명합니다. 비교라면 나란히 놓는 편이, 설명이라면 직접 조작하는 도식이 나을 수 있고, 글로 답하는 편이 가장 쓸모 있으면 글로만 답합니다. 발표가 든 쓰임은 세 가지입니다.
- 일상 질문을 눈으로 보이게: 요리법 옆 조리 시간표, 지도 위 여행 경유지와 메모
- 어려운 주제 배우기: 중심극한정리, GDP, 드론 촬영, 몬티 홀 문제
- 그 자리에서 도구 만들기: 저축 계산기, 비용 나누기, 대화 안에서 하는 레트로 게임
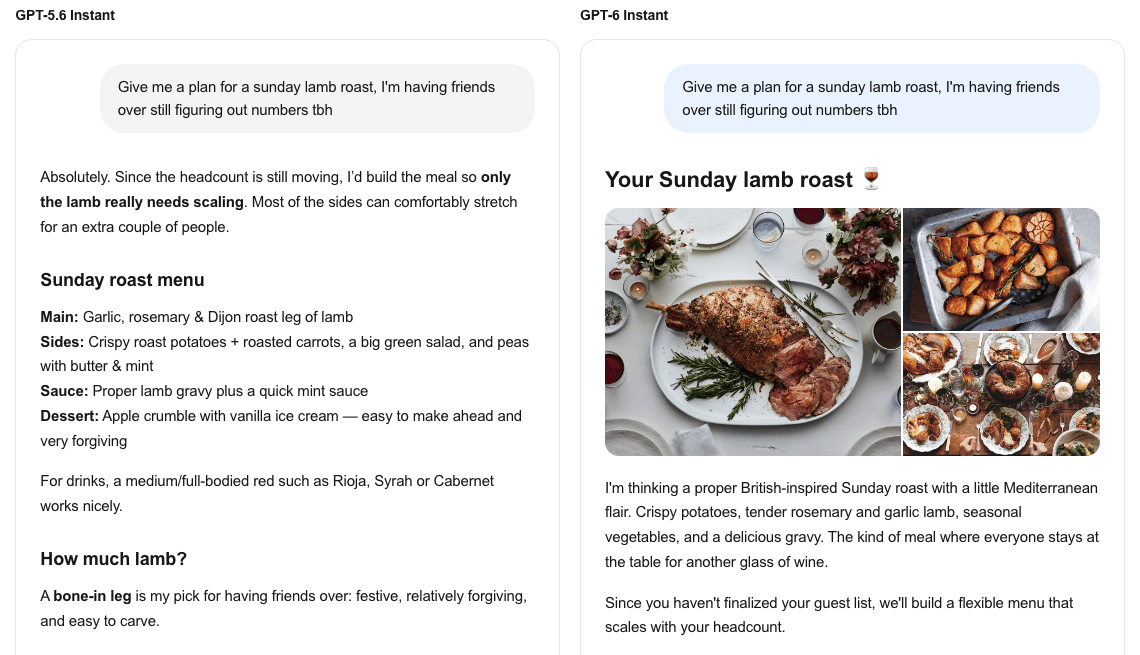
발표 본문의 이 예시에서 GPT-6 답변은 아래로 이어지며 인원수를 바꾸면 장볼 양이 다시 계산되는 입력 칸, 장보기 목록 복사 버튼, 시간대별 조리 체크리스트를 보여 줍니다. 같은 질문에서 GPT-5.6 Instant는 인원별 분량을 표로 적었습니다.
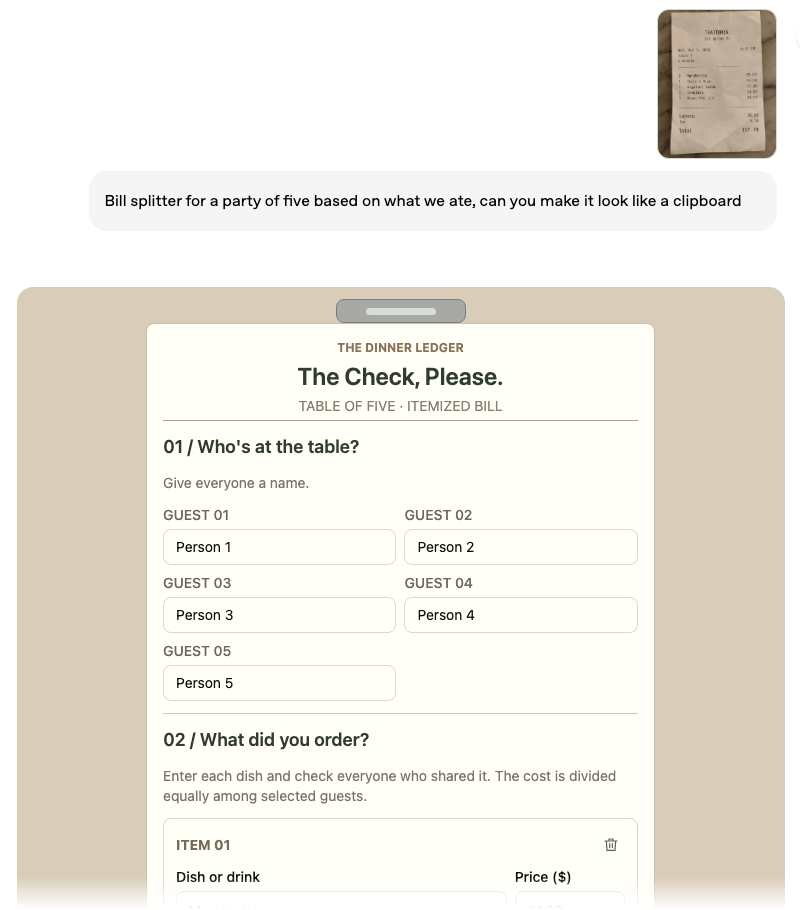
발표가 밝힌 작동 방식은 두 가지입니다.
- 컴포넌트 라이브러리: 웹과 모바일에서 익숙하게 보이도록 미리 만든 화면 부품을 쓰고, 부품을 어떻게 배치할지는 모델이 정한다.
- 컴파일러: 모델이 답을 쓰는 동안 화면을 조금씩 그려, 답이 끝날 때까지 기다리지 않게 한다.
학습 단계에서는 모델이 만든 화면을 명확성, 유용성, 완성도로 평가했다고 합니다. 발표는 디자인 판단을 더 다듬을 여지가 남아 있다고도 적었습니다.
4. 생각하면서 먼저 답하기
답하기 전에 먼저 생각하는 추론 모델이 나온 뒤로는 더 어려운 문제를 맡길 수 있게 됐지만, 생각이 끝날 때까지 답을 기다려야 했습니다. 발표는 GPT-6가 사용자의 대기 시간을 고려해, 그때까지 찾은 내용으로 답을 여러 번에 나눠 쌓도록 학습했다고 설명합니다.
발표가 낸 비교는 세 가지이고, 첫째와 셋째는 OpenAI 사내 평가라고 밝혔습니다.
| 비교 | 발표 내용 |
|---|---|
| GPT-6 Extra High 대 GPT-5.6 | 답을 시작하는 시간은 GPT-5.6 Medium과 같은 수준, 종합 점수는 GPT-5.6 Extra High보다 높음 (여러 단계를 스스로 처리하는 일상 작업 평가) |
| 웹 검색이 필요한 질문 | GPT-6 Instant가 GPT-5.6 Instant보다 평균 44% 빨리 답을 시작 |
| 어려운 문제 | 질문의 핵심을 제대로 다룬 경우가 GPT-5.6보다 많음 |
- 평가 문항과 점수 자체는 발표에 공개되지 않았습니다.
- 언제 검색할지 고르는 판단과 답을 뒷받침하는 정보를 찾는 능력도 나아졌다고 발표는 밝혔습니다.
5. 안전 평가
발표와 시스템 카드에 실린 안전 관련 내용은 나아진 항목과 후퇴한 항목이 함께 있습니다. 따로 적지 않은 비교 대상은 GPT-5.6입니다.
나아진 항목
- 여러 차례 대화를 이어 가며 안전장치를 우회하려는 공격(다회차 탈옥)에 더 강하게 버팁니다. 9월에 Work와 Codex용으로 먼저 나온 Sol, Luna와 비교하면 점수가 조금 낮지만 오차 범위가 대부분 겹칩니다.
- 정직하지 않은 답, 사용자를 속이는 답, 안전장치를 피해 가는 행동이 줄었고, 사실 오류도 거의 모든 평가 지표에서 줄었습니다.
- 답에 필요한 정보나 도구가 없을 때처럼 자기 능력의 한계를 더 잘 알아차리고 알린다고 발표는 설명합니다.
후퇴한 항목
- 일반 평가에서 Sol은 자해, Luna는 자해, 잔혹 묘사, 성적 콘텐츠 항목이 통계적으로 우연이라 보기 어려운 수준(유의)으로 후퇴했습니다.
- 청소년 평가에서는 두 모델 모두 연령 제한 콘텐츠, 성적 콘텐츠, 정서적 의존 항목이, Luna는 잔혹 묘사도 후퇴했습니다. 이미지 입력 평가에서는 극단주의 항목이 후퇴했습니다.
- OpenAI는 위반 응답을 검토해 대체로 심각도가 낮았다고 적었습니다. 정서적 의존 후퇴는 평가가 “bro” 같은 무해한 애칭에 지나치게 민감한 탓으로 보고, 청소년 응답 가운데 자해, 성적 콘텐츠, 잔혹 묘사가 담길 수 있는 답은 자동 판별기로 한 번 더 막고, 이 효과는 평가 수치에 반영되지 않았다고 밝혔습니다.
OpenAI가 고위험 능력을 미리 점검하는 위험 대비 체계(Preparedness Framework)에서는 이번 Sol과 Luna를 사이버보안, 생물과 화학 분야 High 등급으로 취급하고 GPT-5.6과 같은 안전장치를 적용했습니다. 시스템 카드는 사이버보안 High를 사이버 공격의 규모를 키우는 데 걸리던 병목을 없앨 수 있는 수준, 예를 들어 방어가 갖춰진 대상을 향한 공격 전 과정이나 실제로 쓸 만한 취약점의 발견과 악용을 자동화하는 수준으로 정의합니다.
6. 발표에 없는 것
발표, 릴리스 노트, 시스템 카드 어디에도 아래 내용은 적혀 있지 않습니다.
- 일상 대화에서 Sol과 Luna의 답변 품질이 얼마나 다른지
- 인텔리전트 UI를 사용자가 끄거나 켜는 설정이 있는지
- 한국어 답변에서도 같은 화면 요소가 나오는지
- 대화 안에서 만든 계산기나 게임을 대화 밖으로 저장하거나 공유하는 방법
- 개발자가 프로그램에서 모델을 부르는 API에서 같은 기능을 쓸 수 있는지
- 내 계정에 적용됐는지 화면에서 알아보는 표시
댓글