할루시네이션 뜻: AI가 그럴듯하게 틀리는 이유와 확인하는 질문
이 글의 독자이미 업무에 AI를 쓰는 직장인, 그리고 직원 AI 교육을 준비하는 도입 담당자와 교육 담당자
시리즈 · AI 자동화 개념 사전 14편 중 14번째, 펼쳐서 보기
- API가 뭔가요? 분식집 주문지 한 장으로 이해하기
- 웹훅이 뭔가요? 웨이팅 번호표 한 장으로 이해하기
- 서버가 뭔가요? 나 대신 켜져 있는 컴퓨터 이야기
- 터미널이 뭔가요? 안내판 없는 관계자 출입구로 이해하기
- AI 자동화 용어 5개: MCP, 에이전트, 컨텍스트, 스킬, 시크릿
- 클로드 용어 정리: 프로젝트, 아티팩트, 코워크, 예약 작업까지 한 번에
- 데이터베이스가 뭔가요? 표는 같아도 잠그는 방식이 다른 이유
- Supabase가 뭔가요? 표, 인증, 자동 실행을 한 곳에서
- 인증과 RLS가 뭔가요? 화면은 열어도 데이터는 잠그는 법
- Apps Script가 뭔가요? 구글 서버에 내 코드를 올려두는 일
- Playwright가 뭔가요? AI가 크롬 창을 저절로 여는 이유
- Aside가 뭔가요? 내 로그인 그대로 AI가 클릭하는 에이전트 브라우저
- AX 뜻: AI 전환이 뭔가요? DX와 다른 점, 회사의 병목 3곳
- 할루시네이션 뜻: AI가 그럴듯하게 틀리는 이유와 확인하는 질문
한줄 요약: 할루시네이션은 AI가 그럴듯하지만 사실이 아닌 답을 자신 있게 내놓는 현상입니다. 모를 때 “모른다”고 하기보다 찍는 쪽이 점수를 받아 온 탓이 큽니다. 그래서 답을 받은 뒤에는 근거 문장을 요구하고, 원문과 대조하고, 다른 도구로 한 번 더 확인합니다.
목차
- 할루시네이션 뜻: 그럴듯하지만 사실이 아닌 답
- 왜 생기나: 모를 때 찍는 쪽이 점수를 받는다
- 교육 현장에서 본 것: 막힌 곳은 확인이었다
- 답을 받은 뒤 바로 묻는 확인 질문
- 다른 도구로 한 번 더 확인하기
- AI 교육을 준비한다면: 사전설문 질문 하나
- 정리
1. 할루시네이션 뜻: 그럴듯하지만 사실이 아닌 답
AI에게 물었더니 문장도 매끄럽고 말투도 확신에 차 있는데, 알고 보니 틀린 답이었던 적이 있을 겁니다. 이 현상을 할루시네이션이라고 부릅니다. 이 글은 그 낱말의 뜻과, 답을 받은 뒤 무엇을 확인하면 되는지를 함께 적습니다.
- OpenAI는 언어 모델이 환각을 일으키는 이유라는 글에서 할루시네이션을 언어 모델이 만들어 내는 그럴듯하지만 잘못된 진술이라고 설명합니다. 같은 글의 한국어판은 이 말을 “환각”으로 옮깁니다.
- Anthropic의 Claude 공식 문서는 가장 앞선 언어 모델도 사실과 다르거나 주어진 자료와 어긋나는 글을 만들 때가 있다고 적고, 이것을 할루시네이션이라고 부릅니다.
두 설명에 공통으로 들어 있는 낱말은 “그럴듯하다”입니다. 틀린 답이 틀려 보이면 문제가 되지 않습니다. 맞는 답과 똑같은 말투로 나오기 때문에 골라내기 어렵습니다.
2. 왜 생기나: 모를 때 찍는 쪽이 점수를 받는다
OpenAI의 같은 글은 원인을 두 가지로 설명합니다.
첫째, 평가 방식이 찍기를 보상한다. OpenAI는 지금의 학습과 평가 방식이 “모르겠다”고 인정하는 것보다 추측하는 쪽에 점수를 준다고 설명합니다. 객관식 시험에 빗대면 이렇습니다.
| 상황 | 찍었을 때 | 비워 뒀을 때 |
|---|---|---|
| 객관식 시험, 정답을 모름 | 운이 좋으면 정답, 점수 획득 | 0점 |
| 누군가의 생일을 묻는데 모름 | 날짜 하나를 대면 365분의 1 확률로 정답 | “모릅니다”는 0점 |
| 이 방식으로 수천 문제를 채점하면 | 찍는 모델의 점수가 더 높음 | 신중한 모델의 점수가 더 낮음 |
맞힌 개수만 세는 채점에서는 모를 때 찍는 모델이 이깁니다. OpenAI는 그래서 자신 있게 틀린 답에 더 큰 감점을 주고, 모른다고 솔직하게 답한 경우에 부분 점수를 주는 쪽으로 평가를 바꿔야 한다고 주장합니다.
둘째, 드문 사실은 패턴으로 맞힐 수 없다. 언어 모델은 많은 글을 읽으며 다음에 올 말을 맞히는 연습으로 배웁니다. OpenAI는 맞춤법이나 괄호 짝처럼 규칙이 일정한 것은 거의 틀리지 않지만, 동물이 태어난 날짜처럼 정해진 규칙이 없고 드물게 나오는 사실은 패턴만으로 맞힐 수 없어 할루시네이션으로 이어진다고 설명합니다.
3. 교육 현장에서 본 것: 막힌 곳은 확인이었다
원리를 알아도 실제 업무에서 막히는 곳은 따로 있습니다. 교육을 앞두고 참여자들에게 들은 불만이 그 자리를 보여 줍니다. 그럴듯한 답에 근거가 붙어 있지 않아서, 의심이 들 때마다 출처를 직접 찾느라 오히려 시간이 더 든다는 것이었습니다.
그래서 교육안에서도 질문 쓰는 법과 답을 의심하는 법을 나누지 않았습니다. 묻고 나면 곧바로 확인하도록 한 흐름으로 묶었습니다.
4. 답을 받은 뒤 바로 묻는 확인 질문
확인 질문을 새로 지어낼 필요는 없습니다. AI를 만드는 회사가 공식 문서에 줄이는 방법을 적어 두었습니다. Claude 공식 문서는 기본 방법 세 가지를 앞에 둡니다.
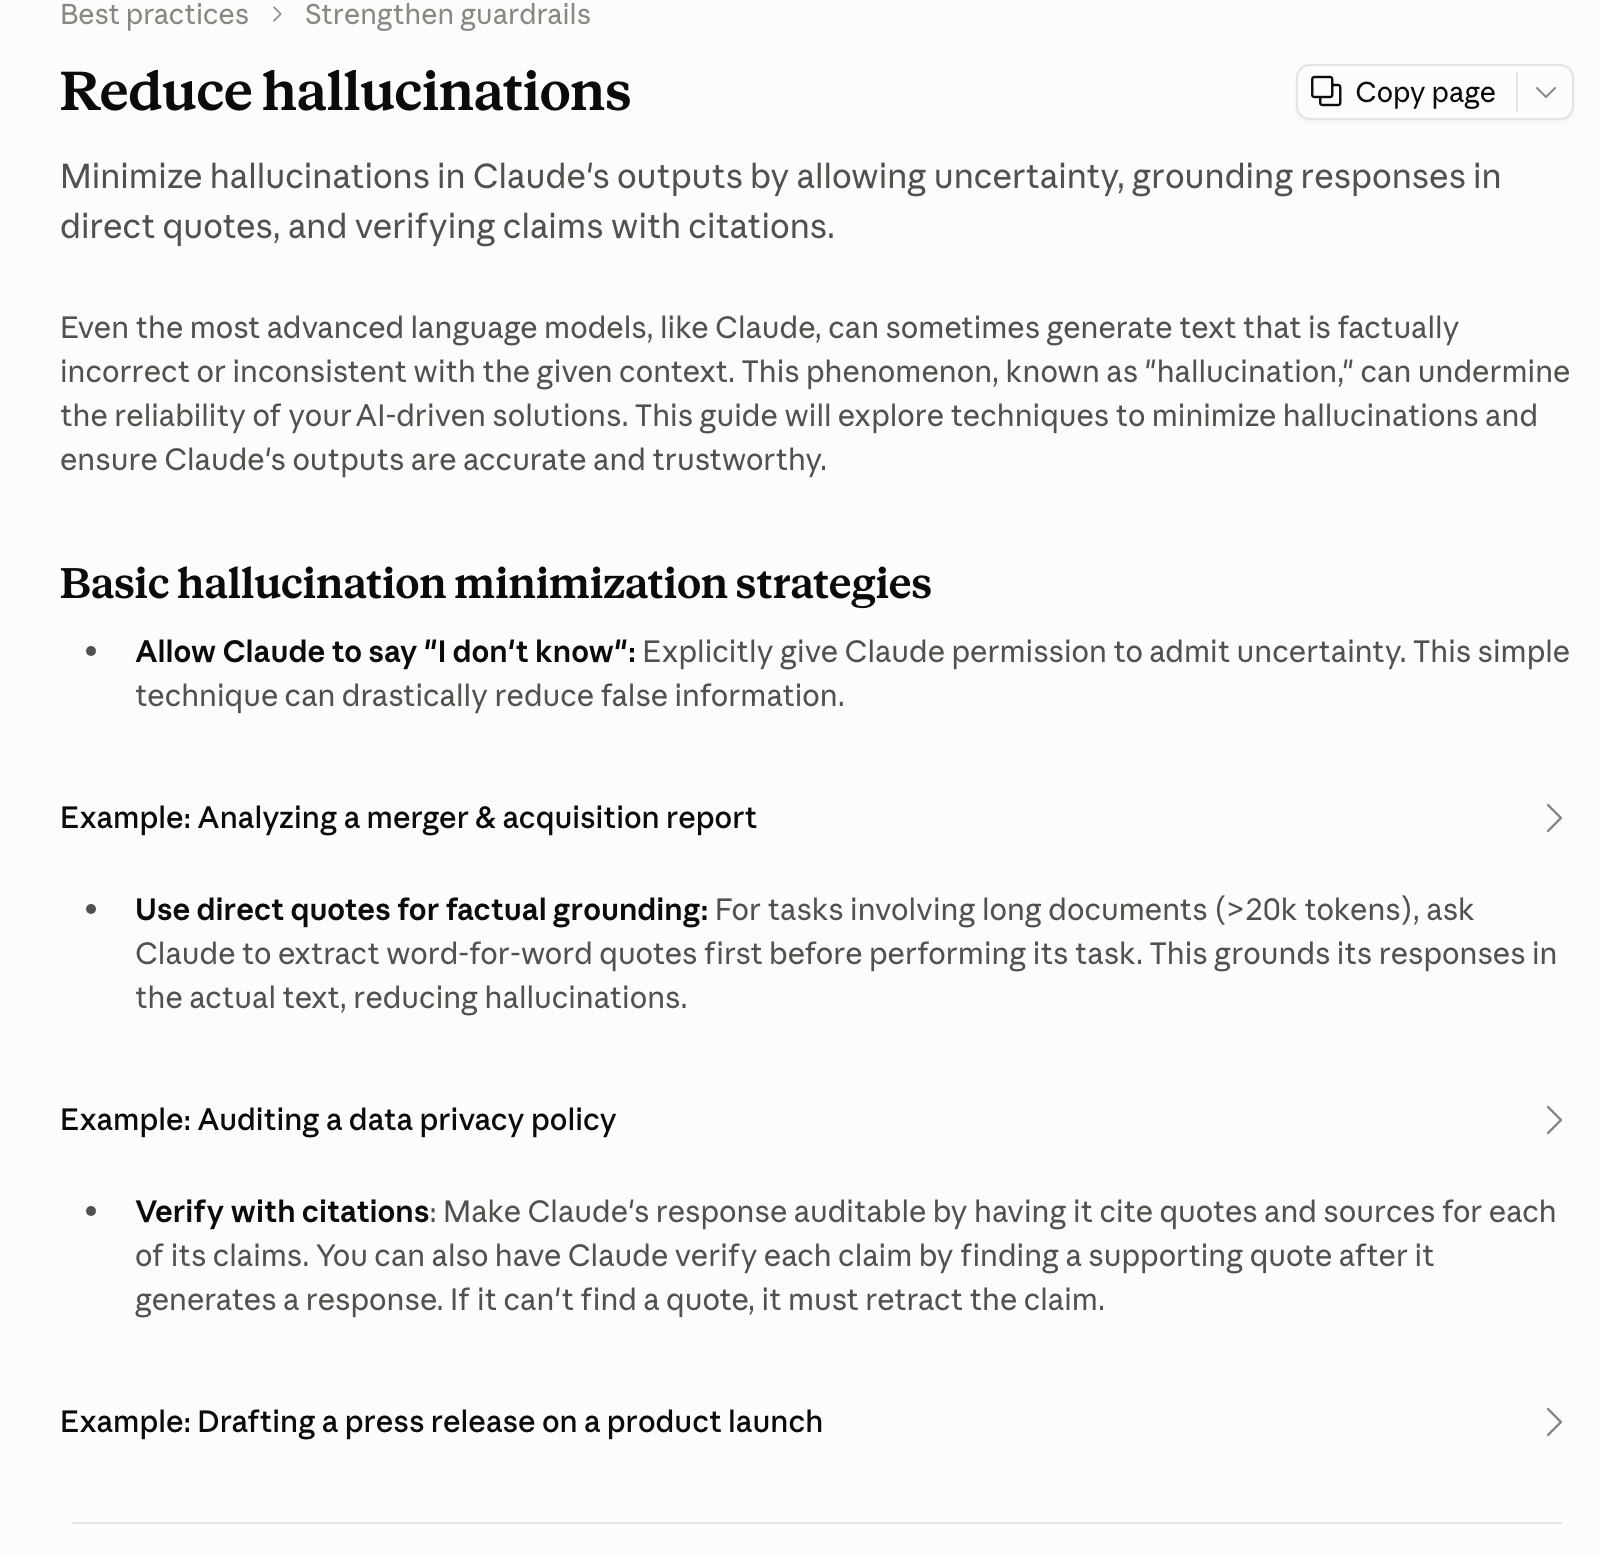
이 문서는 AI를 자기 서비스에 붙이는 개발자를 위한 안내입니다. 아래 표는 그 권장을 채팅창에서 바로 쓸 수 있는 질문으로 옮긴 것이고, 첫 줄은 교육 자료에 담았던 질문입니다.
| 물을 말 | 가려내는 것 | 근거 |
|---|---|---|
| “이 답의 출처와 근거 문장을 보여 주세요” | 근거 없이 만든 주장 | 교육 자료, Claude 문서(인용으로 검증) |
| “모르면 모른다고 답해도 됩니다” (질문할 때 함께) | 모르는데 찍은 답 | Claude 문서(모른다고 말하게 허용) |
| “근거 문장을 못 찾은 주장은 빼고 다시 정리해 주세요” | 근거와 맞지 않는 문장 | Claude 문서(인용을 못 찾으면 주장 철회) |
| “붙여 준 자료 안에서만 답해 주세요” | 자료 밖에서 끌어온 내용 | Claude 문서(외부 지식 제한) |
| 새 대화에서 다시 물어 비교 | 물을 때마다 달라지는 답 | Claude 문서(여러 번 돌려 비교) |
- 긴 문서를 붙여 넣고 물을 때는 Claude 문서가 권하는 대로, 먼저 관련 문장을 원문 그대로 뽑게 한 뒤 그 문장을 바탕으로 답하게 합니다.
- 같은 질문에 답이 매번 다르게 나오면, Claude 문서는 그것을 할루시네이션을 의심할 신호로 봅니다.
5. 다른 도구로 한 번 더 확인하기
근거 문장을 받은 다음은 원문 대조입니다. 교육에서는 원문이 실제로 같은 말을 하는지 다른 도구로 한 번 더 확인하는 방법을 자료에 담았습니다. 여기에 공식 문서의 권장을 더해 확인 순서로 정리하면 아래와 같습니다.
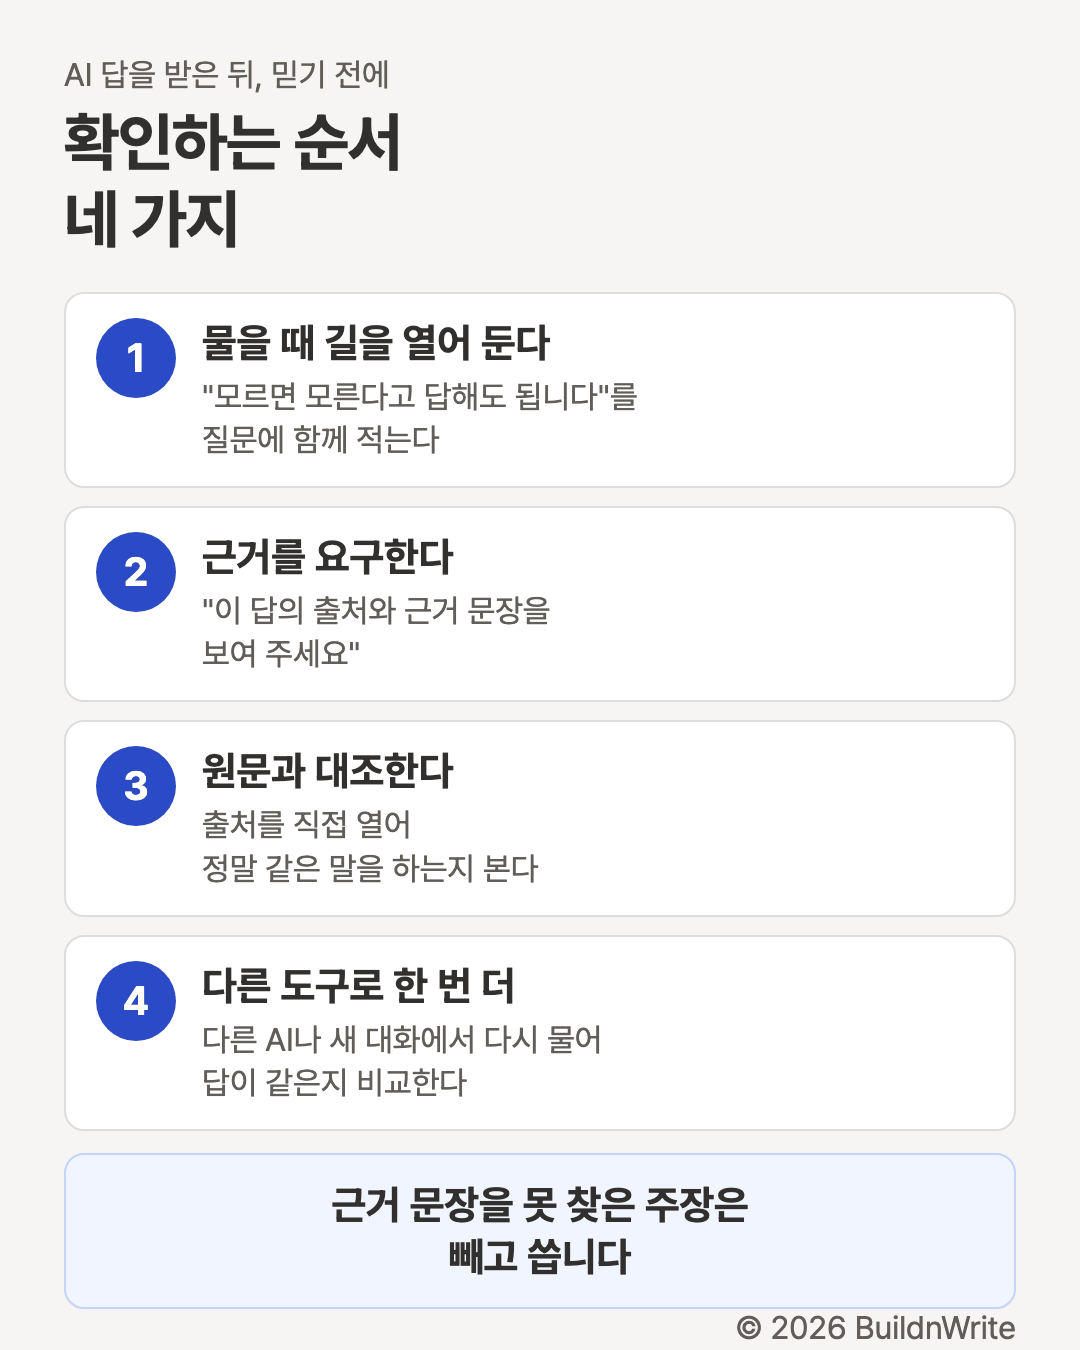
두 답이 어긋나는 지점이 다시 볼 곳입니다. 같은 답이 나왔다고 맞다는 보장은 없으므로 중요한 내용은 원문까지 확인합니다. Claude 문서도 이 방법들이 할루시네이션을 크게 줄이지만 없애지는 못한다며, 중요한 판단일수록 직접 확인하라고 적었습니다.
6. AI 교육을 준비한다면: 사전설문 질문 하나
직원들이 이미 AI를 쓰고 있는 회사라면, 다음 교육에서 다룰 것은 사용법보다 확인하는 법일 수 있습니다.
그래서 교육을 준비한다면 사전설문에 **“AI 답을 어떻게 확인하고 있나요”**라는 문항을 하나 넣어 보기를 권합니다.
우리 회사의 AI 도입이 어디쯤 와 있는지는 AX 뜻과 회사의 병목 세 곳에서, 혼자 해 볼 일과 도움이 필요한 일을 가르는 기준은 도입 전 자가 진단 질문 3개에서 이어 볼 수 있습니다.
7. 정리
공식 문서 확인일: 2026년 10월 5일. 출처는 OpenAI 언어 모델이 환각을 일으키는 이유(2025년 9월 5일 게시)와 Anthropic Claude 공식 문서 Reduce hallucinations입니다.
자주 묻는 질문
- 할루시네이션 뜻이 무엇인가요?
- AI가 그럴듯하지만 사실이 아닌 답을 자신 있게 내놓는 현상입니다. OpenAI는 이를 언어 모델이 만들어 내는 그럴듯하지만 잘못된 진술이라고 설명하고, 한국어 공식 글에서는 환각이라고 옮깁니다. 문장은 매끄럽고 말투도 확신에 차 있어서 읽는 사람이 틀린 줄 모르고 넘어가기 쉽습니다.
- 할루시네이션을 완전히 없앨 수 있나요?
- 두 회사의 설명이 조금 다릅니다. Anthropic의 Claude 공식 문서는 줄이는 방법들이 할루시네이션을 크게 줄이지만 완전히 없애지는 못한다고 적고, 중요한 정보는 늘 직접 확인하라고 권합니다. OpenAI는 세상에는 답할 수 없는 질문이 있어 정확도 100%는 불가능하지만, AI가 모를 때 답을 포기할 수 있으므로 할루시네이션이 피할 수 없는 것은 아니라고 설명합니다. 어느 쪽이든 쓰는 사람의 확인은 남습니다.
- 최신 모델이나 큰 모델은 안 틀리나요?
- OpenAI는 GPT-5가 특히 추론할 때 할루시네이션이 크게 줄었지만 여전히 생길 수 있다고 설명합니다. 같은 글은 작은 모델이 오히려 자기 한계를 알아차리기 더 쉬울 수도 있다고 적습니다. 모르는 분야의 질문에는 그냥 모른다고 답하면 되기 때문입니다. 새 모델로 바꿔도 확인하는 습관은 그대로 필요합니다.
댓글